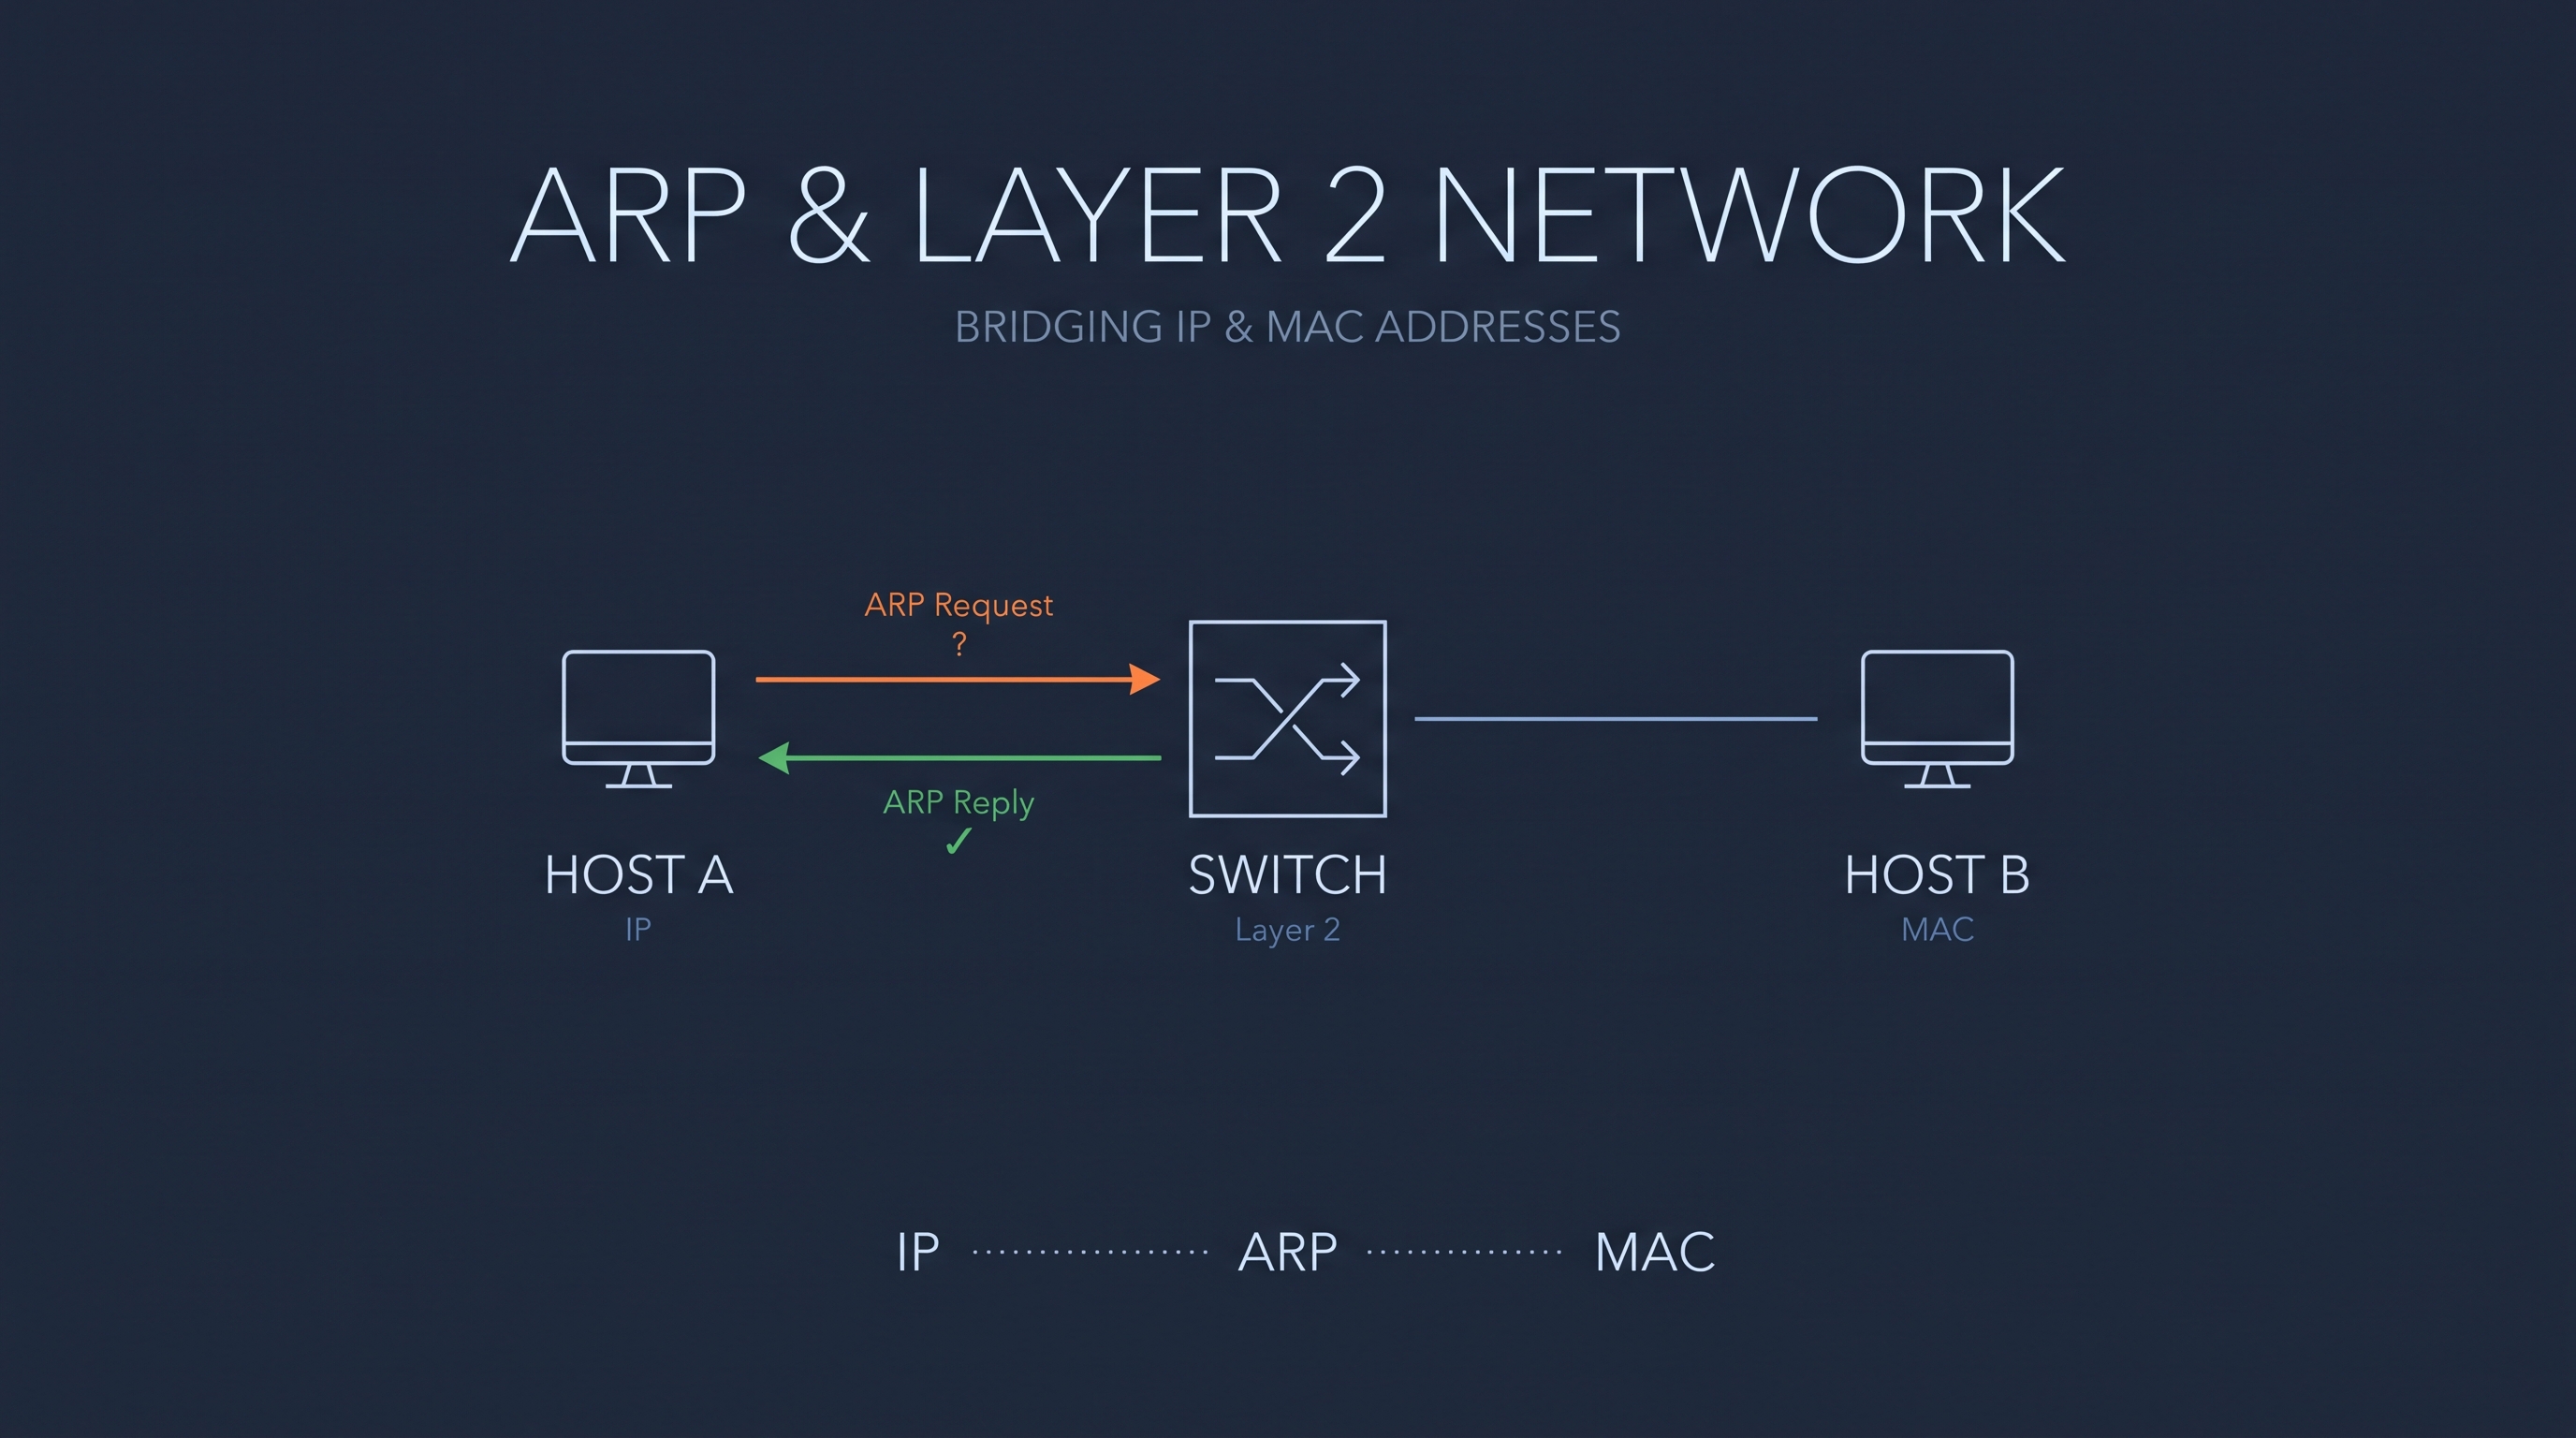
وقتی شبکه قاطی میکند: گشتی در لایه ۲ لینوکس از ARP تا FDB
- لایه ۲ و رابطهاش با لایه ۳
- لینوکس همسایههای شبکه را چطور پیدا میکند
- ساخت یک سوییچ مجازی با FDB
- MAC تکراری؛ وقتی شبکه مقصد را گم میکند
- Netmask، محدوده ARP، و منطق پاسخدهی کرنل
- جمعبندی
وقتی شبکه درست کار نمیکنه، اولین چیزهایی که معمولاً بررسی میکنیم routing و firewall هستن. اما همهی مشکلها هم از این دو تا نیستن. شاید براتون پیش اومده باشه که پینگها گاهی جواب بدن و گاهی نه، ارتباط بین دو سرویس ناپایدار بشه یا سرویسی درست بعد از deployment از دسترس خارج بشه. بعضی وقتها رد این اتفاقها رو باید تو لایهی ۲ پیدا کرد؛ همون لایهای که تا وقتی همهچیز کار میکنه خیلی به چشممون نمیاد.
تو این مقاله میخوام از رابطهی لایههای ۲ و ۳ بگم و ببینیم لینوکس وسط این ماجرا چهکار میکنه: همسایههاش رو چطور پیدا میکنه، FDB توی Linux bridge چه نقشی داره، MAC تکراری چطور شبکه رو به دردسر میاندازه و netmask چه ربطی به ARP داره. آخرش هم سراغ این میریم که کرنل چه وقت به ARP request جواب میده و چه وقت بیخیالش میشه.
لایه ۲ و رابطهاش با لایه ۳
مدل OSI شبکه رو به چند لایه تقسیم میکنه. از بین این لایهها، مرز لایهی ۲ (Data Link) و لایهی ۳ (Network) برای فهمیدن اینکه ترافیک چطور حرکت میکنه خیلی مهمه.
لایهی ۳ با IP address و routing سروکار داره؛ یعنی مشخص میکنه بسته برای رسیدن به مقصد از چه مسیری باید بره و از کدوم روترها عبور کنه.
لایهی ۲ با MAC address و frame سروکار داره و به ارتباط دستگاههایی مربوطه که روی یک لینک یا توی یک broadcast domain قرار گرفتن.
Src MAC
Ethertype"] L3["Src IP
Dst IP
TTL/Proto"] PL["TCP/UDP
Payload"] L2B["FCS"] L2A --> L3 --> PL --> L2B style L2A fill:#1565c0,stroke:#0d47a1,color:#fff style L3 fill:#2e7d32,stroke:#1b5e20,color:#fff style PL fill:#f5f5f5,stroke:#9e9e9e,color:#444 style L2B fill:#1565c0,stroke:#0d47a1,color:#fff
وقتی کرنل میخواد بستهای رو بفرسته، اول از routing table میپرسه که مقصد از کدوم مسیر در دسترسه. ولی دانستن IP مقصد برای فرستادن بسته روی اترنت کافی نیست. باید بسته رو داخل یک Ethernet frame بذاریم و برای این کار MAC مقصد رو هم بدونیم. اینجاست که لایهی ۳ به لایهی ۲ وابسته میشه و ARP به کار میاد.
به نظرم این جمله اصل رابطهی این دو لایه رو خوب جمع میکنه: IP routing مسیر رو انتخاب میکنه؛ Ethernet بسته رو توی هر لینک به hop بعدی میرسونه. هر بار که بسته از روتر رد میشه، frame قبلی کنار میره و برای لینک بعدی یک frame تازه با MACهای مناسب ساخته میشه. هدر IP راهش رو تا مقصد ادامه میده، اما هدر Ethernet فقط برای همون یک لینک عمر میکنه.
192.168.1.10"] R1("Router 1
Home gateway
(strip / rewrite)") R2("Router 2
ISP core
(strip / rewrite)") S["Server
93.184.216.34"] H -->|"Link 1
Src: host
Dst: R1"| R1 R1 -->|"Link 2
Src: R1
Dst: R2"| R2 R2 -->|"Link 3
Src: R2
Dst: srv"| S end %% Styling style H fill:#1565c0,stroke:#0d47a1,color:#fff style S fill:#1565c0,stroke:#0d47a1,color:#fff style R1 fill:#ef6c00,stroke:#e65100,color:#fff style R2 fill:#ef6c00,stroke:#e65100,color:#fff
یک نکتهی کوچک دربارهی هدر Ethernet: فیلد Ethertype به گیرنده میگه داخل frame با چی طرفه؛
0x0800برای IPv4،0x86DDبرای IPv6 و0x0806برای خود ARP.
لینوکس همسایههای شبکه را چطور پیدا میکند
برای اینکه هر بار از اول دنبال MAC مقصد نگرده، لینوکس نگاشت IP به MAC رو توی neighbour table نگه میداره. این جدول همسایههایی رو شامل میشه که از یک رابط شبکه و بهصورت مستقیم قابل دسترس هستن. برای دیدنش کافیه ip neigh show رو اجرا کنید؛ arp -n هم دستور قدیمیتریه که اطلاعات مشابهی نشون میده.
ARP، قدمبهقدم
10.0.0.1 participant B as Host B
10.0.0.2 A->>B: ARP Request (broadcast)
who has 10.0.0.2? tell 10.0.0.1 Note over A,B: dst MAC: ff:ff:ff:ff:ff:ff B->>A: ARP Reply (unicast)
10.0.0.2 is at aa:bb:cc:dd:ee:02 Note over A: Cache: 10.0.0.2 → aa:bb:cc:dd:ee:02
state: REACHABLE
فرض کنید Host A میخواد به Host B بسته بفرسته، ولی MAC مربوط به IP اون رو نمیدونه. یک ARP request به آدرس broadcast اترنت یعنی ff:ff:ff:ff:ff:ff میفرسته و همهی دستگاههای همون broadcast domain درخواست رو میبینن. دستگاهی که IP موردنظر رو داره معمولاً با یک پاسخ unicast جواب میده. لینوکس این نگاشت رو توی cache نگه میداره؛ اگر همسایه در اون لحظه قابلدسترسی تشخیص داده شده باشه، state اون entry معمولاً REACHABLE میشه.
وضعیتهای neighbour entry
این entryها برای همیشه معتبر نمیمونن. کرنل برای هرکدوم یک state نگه میداره تا بدونه نگاشت هنوز قابل اعتماده یا باید دوباره بررسیش کنه. توی نمودار زیر چند state پرکاربرد رو میبینید:
ARP رفت، منتظر جواب"] REA["REACHABLE
تایید شده"] STA["STALE
تایمر تموم شده"] DEL["DELAY
منتظر تایید لایه بالاتر"] PRO["PROBE
ARP unicast میفرسته"] FAI["FAILED
بدون جواب، حذف شد"] INC -->|جواب رسید| REA INC -->|بدون جواب| FAI REA -->|تایمر تموم شد| STA STA -->|پکت جدید| DEL DEL -->|تایید نشد| PRO PRO -->|جواب رسید| REA PRO -->|بدون جواب| FAI style REA fill:#2e7d32,stroke:#1b5e20,color:#fff style FAI fill:#c62828,stroke:#b71c1c,color:#fff style INC fill:#f9a825,stroke:#f57f17,color:#000
$ ip neigh show dev eth0
10.0.0.1   lladdr aa:bb:cc:dd:ee:01  REACHABLE
10.0.0.254 lladdr aa:bb:cc:dd:ee:fe  STALE
10.0.0.10  INCOMPLETE
اگر لازم شد رفتار این تایمرها رو بررسی یا تنظیم کنید، از مسیر /proc/sys/net/ipv4/neigh/<iface>/ شروع کنید. گزینههایی که معمولاً توی عیبیابی به چشم میخورن gc_stale_time، base_reachable_time_ms و retrans_time_ms هستن.
برای دیدن اینکه واقعاً چه ARPای روی اینترفیس ردوبدل میشه، من معمولاً از tcpdump -n -e -i eth0 arp شروع میکنم. گزینهی -e MACها رو هم نشون میده و کمک میکنه اطلاعات دو لایه رو کنار هم ببینیم.
ساخت یک سوییچ مجازی با FDB
سوییچ اترنت با نگاه کردن به frameهای ورودی یاد میگیره هر MAC از کدوم پورت میاد. Linux bridge هم همین کار رو میکنه. جدولی که این نگاشت MAC به پورت رو نگه میداره Forwarding Database یا همون FDBه.
ساخت bridge
# ساخت bridge
ip link add name br0 type bridge
ip link set br0 up
# اضافه کردن اینترفیسها به عنوان پورت
ip link set eth0 master br0
ip link set veth1 master br0
# دیدن entry هایی که به صورت خودکار یاد گرفته
bridge fdb show dev br0
بذارید ببینیم این یادگیری چه شکلیه: وقتی frameای وارد bridge میشه، کرنل MAC مبدا رو میبینه و یاد میگیره این MAC پشت کدوم پورت قرار داره. بعد اگر MAC مقصد رو توی FDB بشناسه، frame رو از همون پورت میفرسته. اگر نشناسه، به پورتهای مناسب دیگه flood میکنه. برای همین Linux bridge از این نظر خیلی شبیه یک سوییچ اترنت رفتار میکنه.
انواع entry در FDB
وقتی خروجی FDB رو میبینید، ممکنه کنار entryها چند فلگ هم ببینید. معنی چند مورد مهمشون اینه:
| فلگ | معنی |
|---|---|
master |
متعلق به bridge است؛ entryهای پویا معمولاً به این شکل مدیریت میشوند |
self |
متعلق به خود دستگاه است؛ از جمله در برخی سناریوهای VXLAN یا hardware offload |
permanent |
ثابت است و بهصورت خودکار منقضی نمیشود |
local |
آدرس MAC خود bridge؛ فریمهای مقصد این آدرس در همان میزبان پردازش میشوند |
FDB استاتیک در VXLAN
حالا اگر VXLAN داشته باشیم، FDB فقط به MACهای روی پورتهای محلی محدود نمیمونه. دستگاه tunnel مربوط به VXLAN مثل یک پورت دیگه به bridge وصل میشه و میتونیم MAC راه دور رو به IP مربوط به VTEP نگاشت کنیم:
# پین کردن دستی یه MAC راه دور به یه VTEP
bridge fdb add aa:bb:cc:dd:ee:02 dev vxlan100 dst 192.168.1.20 self permanent

# یا پاک کردن همه dynamic entry ها برای force re-learning
bridge fdb flush dev br0
aa:bb:cc:01 → port 1
aa:bb:cc:02 → port 2
aa:bb:cc:03 → vxlan100/VTEP"] end P1["port 1
veth0 / eth0"] P2["port 2
veth1 / veth2"] VX["vxlan100
tunnel port"] FDB --- P1 FDB --- P2 FDB --- VX style FDB fill:#1565c0,stroke:#0d47a1,color:#fff style VX fill:#e65100,stroke:#bf360c,color:#fff style Bridge fill:#e3f2fd,stroke:#90caf9
اینجا یک تفاوت مهم bridge و router هم روشن میشه: FDB خودش فقط MAC رو میشناسه، نه IP رو. bridge بر اساس MAC frame رو forward میکنه. البته وقتی VXLAN یا EVPN وسط باشه، control plane میتونه نگاشت MAC/IP رو بین datacenterها پخش کنه؛ ولی این اطلاعات از خود FDB به دست نمیاد.
MAC تکراری؛ وقتی شبکه مقصد را گم میکند
روی کاغذ هر رابط شبکه باید MAC منحصربهفرد خودش رو داشته باشه. ولی توی دنیای واقعی، clone کردن VM، template اشتباه یا یک misconfiguration ساده میتونه باعث بشه چند سیستم با یک MAC بالا بیان. نتیجهاش هم همیشه قطع کامل شبکه نیست؛ گاهی ارتباط فقط یکبار وصله و یکبار نیست و همین پیدا کردن علت رو سخت میکنه.
چه اتفاقی میفته؟
فرض کنید دو هاست توی یک broadcast domain با MAC یکسان روشن باشن. دقیقاً چه اتفاقی میافته؟ بسته به توپولوژی و رفتار هاستها، چند جور دردسر ممکنه ببینیم:
⚠️ قاطی شدن ARP: اگر هر دو هاست برای IPهایشان جواب ARP بفرستن، فرستنده ممکنه neighbour entry رو یک بار با اطلاعات یکی و بار دیگه با اطلاعات اون یکی بهروز کنه. در نتیجه ترافیک قابل پیشبینی به مقصد نمیرسه. این وضعیت لزوماً حملهی ARP poisoning نیست، ولی از بیرون میتونه شبیه یک مشکل ARP به نظر بیاد.
⚠️ بههمریختن FDB سوییچ: سوییچهای مسیر frameهایی با یک MAC مبدا رو از پورتهای مختلف میبینن و مدام entry اون MAC رو جابهجا میکنن. این اتفاق میتونه باعث بشه ترافیک unicast به پورت اشتباهی بره یا flood بشه. اگر ترافیک زیاد باشه، مشکل ممکنه بخش بزرگتری از VLAN رو هم درگیر کنه.
🔴 اطلاعات قدیمی در neighbour cache: ممکنه لینوکس MACای رو برای مقصد cache کرده باشه که دیگه درست نیست. بعد از رفع مشکل هم entryهای قبلی لزوماً همون لحظه پاک نمیشن. اگر مطمینید مشکل از تکراری بودن MAC بوده و میخواید cache اینترفیس رو پاک کنید، این دستور رو دارید:
ip neigh flush dev eth0
از کجا بفهمیم MAC تکراری داریم؟
# جستوجوی پیامهای مربوط به آدرس تکراری در لاگ کرنل
dmesg | grep -i "duplicate address detected"
# مشاهدهی پاسخهای gratuitous ARP از MACهای غیرمنتظره
tcpdump -n -e -i eth0 'arp[6:2] == 2'
# بررسی entryهایی که سیستم یاد گرفته است
ip neigh show | sort
حواسمون به templateهای VM باشه
به نظرم یکی از اولین جاهایی که باید توی زیرساخت مجازی بررسی کنیم، templateها هستن. اگر موقع clone شدن MAC تازهای برای رابط شبکه ساخته نشه، چند VM ممکنه با یک آدرس بالا بیان. بعضی ابزارها، از جمله cloud-init یا بعضی Terraform providerها، توی این کار کمک میکنن؛ ولی بهتره فرض نکنیم هر روش cloneای، از virt-clone گرفته تا full clone در VMware، حتماً MAC رو عوض میکنه. بعد از بوت هم با ip link show میتونیم آدرسها رو چک کنیم.
توی استقرارهای RKE2/Rancher هم MAC تکراری روی VMهای node میتونه ARP flapping درست کنه. چیزی که از دید ما شاید فقط یک ارتباط ناپایدار باشه، برای سرویسهایی مثل Cilium و CoreDNS خودش رو به شکل مشکل دسترسی در لایهی ۲ نشون میده.
Netmask، محدوده ARP، و منطق پاسخدهی کرنل
تا اینجا بیشتر دربارهی پیدا کردن MAC و forward کردن frame حرف زدیم. حالا میخوام برم سراغ جایی که تنظیمات IP هم مستقیم وارد بازی میشن: اینکه لینوکس برای چه مقصدی ARP میفرسته و اصلاً به کدوم ARP requestها جواب میده.
Netmask محدوده ARP رو تعریف میکنه
برای فهمیدن این موضوع، اول باید ببینیم مقصد از نظر لینوکس on-link حساب میشه یا نه. اگر مقصد مستقیم توی همون شبکهی لایهی ۲ باشه، لینوکس برای خود اون مقصد ARP میفرسته. اگر نباشه، معمولاً باید بسته رو به gateway بده و در نتیجه MAC خود gateway رو پیدا میکنه. netmask توی این تشخیص نقش داره، هرچند routing table هم میتونه مسیرهای دقیقتری تعریف کرده باشه.
10.0.0.1/24"] B["Host B
10.0.0.2/24"] GW["Gateway
10.0.0.254/24"] end EXT["10.1.0.5
(outside /24)"] A -->|"ARP: who has .2?"| B A -->|"dst 10.1.0.5
→ ARP for gateway MAC"| GW GW -.->|routes to| EXT style A fill:#1565c0,stroke:#0d47a1,color:#fff style B fill:#2e7d32,stroke:#1b5e20,color:#fff style GW fill:#e65100,stroke:#bf360c,color:#fff style LAN fill:#e3f2fd,stroke:#90caf9
یک مثال ساده: Host A با آدرس 10.0.0.1/24، شبکهی 10.0.0.0/24 رو on-link میدونه و برای پیدا کردن MAC میزبانهای این محدوده ARP میفرسته. اما برای 10.1.0.5، اگر route خاصی نداشته باشیم، بسته رو به default gateway میده. پس MACای که resolve میشه MAC دروازهست، نه سرور نهایی.
arp_ignore؛ چه زمانی پاسخ بدهیم؟
حالا فرض کنید ARP request به یکی از اینترفیسهای لینوکس رسیده. آیا کرنل همیشه جواب میده؟ نه. یکی از تنظیماتی که روی این رفتار اثر میذاره net.ipv4.conf.<iface>.arp_ignoreه:
| مقدار | رفتار |
|---|---|
0 (پیشفرض) |
به هر ARP request برای هر IP محلی جواب میده، فارغ از اینکه از کدوم اینترفیس اومده |
1 |
فقط جواب میده اگه IP مقصد به همون اینترفیسی که request ازش رسیده تعلق داشته باشه |
2 |
فقط جواب میده اگه IP مقصد روی همون subnet IP مبدا و روی اینترفیس ورودی باشه |
8 |
هیچ وقت جواب نمیده (برای loopback، dummy interface و …) |
این تنظیم توی سرورهای multi-homed و بعضی پیکربندیهای LVS مهم میشه. مثلاً وقتی چند node یک VIP مشترک دارن، شاید بخوایم فقط اینترفیس مشخصی به ARP جواب بده. البته مقدار درست رو باید با توجه به طراحی شبکه انتخاب کرد؛ صرفاً کپی کردن یک sysctl از روی یک راهنما همیشه جواب نمیده.
arp_announce؛ انتخاب IP مبدا
arp_announce سمت دیگهی ماجراست: وقتی خود لینوکس ARP request میفرسته، این تنظیم مشخص میکنه کدوم IP رو بهعنوان مبدا اعلام کنه. روی سیستمی که چند رابط شبکه داره، این انتخاب میتونه مهم باشه:
| مقدار | رفتار |
|---|---|
0 |
از هر آدرس محلی (پیشفرض؛ روی multi-homed میتونه مشکل ایجاد کنه) |
1 |
ترجیح میده از آدرسی از subnet مقصد استفاده کنه اگه وجود داشته باشه |
2 |
همیشه از بهترین آدرس محلی برای اینترفیس خروجی استفاده میکنه (توصیهشده برای multi-homed) |
# نمونهای از تنظیم رایج در برخی پیکربندیهای Kubernetes و LVS
sysctl -w net.ipv4.conf.all.arp_ignore=1
sysctl -w net.ipv4.conf.all.arp_announce=2
کرنل چه زمانی به ARP request پاسخ نمیدهد؟
پس تا اینجا دیدیم که رسیدن ARP request به اینترفیس الزاماً به معنی جواب گرفتن نیست. کرنل چند تا شرط رو بررسی میکنه و اگر یکی از اینها برقرار نباشه، ممکنه اصلاً پاسخی نفرسته:
یه اینترفیس محلیه؟"} CHK2{"arp_ignore >= 1؟
IP روی اینترفیس
ورودیه؟"} CHK3{"اینترفیس
فلگ NOARP داره؟"} CHK4{"arp_filter فعاله
و RPF مبدا رو
رد میکنه؟"} DROP["DROP"] REPLY["ARP Reply بفرست"] RCV --> CHK1 CHK1 -->|نه| DROP CHK1 -->|آره| CHK3 CHK3 -->|آره| DROP CHK3 -->|نه| CHK2 CHK2 -->|رد شد| DROP CHK2 -->|قبول شد| CHK4 CHK4 -->|رد شد| DROP CHK4 -->|قبول شد| REPLY style DROP fill:#c62828,stroke:#b71c1c,color:#fff style REPLY fill:#2e7d32,stroke:#1b5e20,color:#fff style RCV fill:#1565c0,stroke:#0d47a1,color:#fff
یک نکته دربارهی Kubernetes: قبل از اینکه
arp_ignoreوarp_announceرو روی nodeها دستی تغییر بدید، ببینید شبکهی کلاستر چطور ازشون استفاده میکنه. kube-proxy، Cilium و تنظیمات سرویسها ممکنه به این رفتار وابسته باشن؛ یک override اشتباه میتونه دسترسی به service IPها رو خراب کنه یا موقع رخدادهای کلاستر تعداد زیادی gratuitous ARP تولید کنه.
Gratuitous ARP؛ اعلام تغییر
گاهی یک دستگاه لازم داره بدون اینکه کسی ازش پرسیده باشه بگه «این IP رو من دارم». یکی از راههاش Gratuitous ARPه: پیامی که بدون request قبلی فرستاده میشه و معمولاً IP مبدا و مقصدش یکیه. لینوکس ممکنه موقع بالا اومدن interface، اضافه شدن IP یا failover چنین پیامی بفرسته تا بقیهی دستگاههای سگمنت neighbour cacheشون رو بهروز کنن. از همین پیامها میشه برای پیدا کردن تداخل IP هم کمک گرفت. برای فرستادن دستی نمونهای از اون:
arping -c 3 -A -I eth0 10.0.0.1
برای همین keepalived، VRRP و Cilium بعد از failover از این سازوکار استفاده میکنن تا بقیهی شبکه متوجه بشه VIP حالا روی MAC جدیدی قرار گرفته.
جمعبندی
حرف اصلی این مقاله برای من اینه که لایهی ۲ و ۳ رو موقع عیبیابی نمیشه از هم جدا کرد. برای اینکه یک IP packet به مقصد برسه، باید هم مسیر IP مشخص باشه و هم معلوم بشه frame به کدوم MAC بره. ARP این دو مرحله رو به هم وصل میکنه، neighbour table نگاشت IP و MAC رو نگه میداره و FDB توی bridge میگه frame از کدوم پورت خارج بشه. تنظیماتی مثل arp_ignore و arp_announce هم تعیین میکنن کرنل چطور با درخواستهای ARP برخورد کنه.
پس دفعهی بعد که با پینگ ناموفق یا ارتباط ناپایدار روبهرو شدید، فقط سراغ routing و firewall نرید. من جای شما بودم neighbour table، FDB و تنظیمات ARP رو هم بررسی میکردم؛ خیلی وقتها سرنخ اصلی همونجاست.