<?xml version="1.0" encoding="utf-8"?><feed xmlns="http://www.w3.org/2005/Atom" ><generator uri="https://jekyllrb.com/" version="3.10.0">Jekyll</generator><link href="https://behroozam.com/feed.xml" rel="self" type="application/atom+xml" /><link href="https://behroozam.com/" rel="alternate" type="text/html" /><updated>2026-06-29T23:32:34+00:00</updated><id>https://behroozam.com/feed.xml</id><title type="html">بهروزم</title><subtitle>بهروزم جایی که یاد گرفتم بهبود یه تلاش دائمی است
</subtitle><author><name>Behrouz Hasanbeygi</name></author><entry><title type="html">ساختن کلاستر کوبرنتیز با رنچر روی هاروستر و اندکی گیک بازی</title><link href="https://behroozam.com/harvester-homelab-setup.html" rel="alternate" type="text/html" title="ساختن کلاستر کوبرنتیز با رنچر روی هاروستر و اندکی گیک بازی" /><published>2026-04-27T00:00:00+00:00</published><updated>2026-04-27T00:00:00+00:00</updated><id>https://behroozam.com/harvester-homelab-setup</id><content type="html" xml:base="https://behroozam.com/harvester-homelab-setup.html"><![CDATA[<h2 id="مقدمه-اکوسیستم-rancher">مقدمه: اکوسیستم Rancher</h2>

<p>توی دنیای self-hosted راه‌های زیادی برای ساختن کلاستر Kubernetes وجود داره، ولی یکی از ابزارهایی که خیلی محبوب و پر استفاده‌ست اکوسیستم Rancher‌ه. قبل از اینکه بریم سراغ مراحل عملی، یه توضیح اجمالی بدم درباره پروژه‌های اصلی که زیرمجموعه Rancher هستن و به چه کار می‌آن:</p>

<script src="assets/js/mermaid.min.js"></script>
<div class="mermaid">
graph TD
    %% تعریف ساختار هرمی با استفاده از زیرمجموعه‌ها

    subgraph Top [PaaS]
        RKE2["<b>RKE2</b><br />(کلاستر کوبرنتیز امن و سبک)"]
    end

    subgraph Middle [Management &amp; Control]
        RM["<b>Rancher Manager</b><br />(کنترل و مشاهده کل کلاسترها)"]
        H["<b>Harvester</b><br />(زیرساخت مجازی سازی و HCI)"]
    end

    subgraph Base [Foundation]
        LH["<b>Longhorn Storage</b><br />(ذخیره‌سازی توزیع شده)"]
        VM["<b>Virtual Compute</b>"]
    end

    %% ایجاد سلسله مراتب بصری
    RKE2 --- RM
    RM --- H
    H --- LH
    H --- VM

    %% استایل‌دهی برای نمایش بهتر
    style RKE2 fill:#ffeb3b,stroke:#fbc02d,stroke-width:3px
    style RM fill:#2196f3,stroke:#1976d2,color:#fff
    style H fill:#ff9800,stroke:#f57c00,color:#fff
    style Top fill:none,stroke:none
    style Middle fill:none,stroke:none
    style Base fill:#f5f5f5,stroke:#9e9e9e,stroke-dasharray: 5 5
</div>

<ul>
  <li><strong>Rancher Manager (Rancher UI):</strong> وظیفه ساختن و مدیریت کلاسترهای Kubernetes رو داره. از اینجاست که همه چیز رو می‌بینیم و کنترل می‌کنیم.</li>
  <li><strong>Harvester:</strong> یه پلتفرم مجازی‌سازی هایپرکانورجد هست که virtual machine و distributed storage رو با هم بهمون می‌ده. زیر بنای storage‌ش هم <strong>Longhorn</strong> ه.</li>
  <li><strong>RKE2:</strong> یه توزیع سبک Kubernetes بر مبنای k3s‌ه که تمرکزش روی امنیت، سرعت و سازگاری با اکوسیستم Rancher و Longhorn هست.</li>
</ul>

<p>پس از نظر لایه‌بندی می‌شه گفت:</p>

<ul>
  <li><strong>لایه IaaS</strong> ← Harvester</li>
  <li><strong>لایه Platform (PaaS)</strong> ← RKE2 + Rancher</li>
</ul>

<h2 id="چرا-harvester-و-یه-هشدار-مهم">چرا Harvester؟ (و یه هشدار مهم)</h2>

<p>توی <a href="/proxmox-pxe-boot">پست قبلی</a> توضیح دادم که چطور با Netboot و dnsmasq روی لپ‌تاپم
Proxmox نصب کردم. اما در میانه‌ی راه تصمیم گرفتم مسیرم رو عوض کنم و به سمت Harvester برم.</p>

<h3 id="فروپاشی-اکوسیستم-vmware">فروپاشی اکوسیستم VMware</h3>

<p>احتمالاً خبر دارید که بعد از تصاحب VMware توسط Broadcom، هزینه‌ها و پیچیدگی‌های لایسنس
به شکل چشمگیری افزایش پیدا کرد. از نسخه‌ی ۸ به بعد، مدل لایسنس‌دهی به سمتی رفت که
عملاً بازیگرهای کوچک و متوسط رو از معادله حذف می‌کنه. علاوه بر این، حتی برای
provisioning اولیه هم به منابع سخت‌افزاری قابل‌توجهی نیاز داره.</p>

<p>این تغییرات برای تیم‌ها و شرکت‌هایی که زیرساختشون رو روی VMware بنا کرده بودن یک
زنگ خطر جدی بود و جستجو برای جایگزین رو اجتناب‌ناپذیر کرد.</p>

<h3 id="harvester-بهعنوان-جایگزین-واقعی">Harvester به‌عنوان جایگزین واقعی</h3>

<p>Harvester یک پلتفرم HCI (Hyper-Converged Infrastructure) متن‌بازه است که توسط SUSE
پشتیبانی می‌شه. این پشتیبانی از یک شرکت enterprise معتبر، یعنی چرخه‌ی پشتیبانی بلندمدت،
patch های امنیتی منظم، و SLA قابل استناد — چیزهایی که برای زیرساخت production حیاتی‌اند.</p>

<h2 id="چرا-harvester-و-نه-proxmox">چرا Harvester و نه Proxmox؟</h2>

<p>هر دو پلتفرم مجازی‌سازی و Software-Defined Storage رو ارائه می‌دن:</p>

<table>
  <thead>
    <tr>
      <th>ویژگی</th>
      <th>Harvester</th>
      <th>Proxmox</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>مجازی‌سازی</td>
      <td>KubeVirt</td>
      <td>KVM/QEMU</td>
    </tr>
    <tr>
      <td>Storage</td>
      <td>Longhorn</td>
      <td>Ceph</td>
    </tr>
    <tr>
      <td>لایه مدیریتی</td>
      <td>Kubernetes-native</td>
      <td>اختصاصی</td>
    </tr>
    <tr>
      <td>یکپارچگی با Rancher</td>
      <td>بله (built-in)</td>
      <td>خیر</td>
    </tr>
    <tr>
      <td>مدل لایسنس</td>
      <td>متن‌باز (Apache 2.0)</td>
      <td>BSL / Enterprise</td>
    </tr>
  </tbody>
</table>

<h3 id="مزیتهای-کلیدی-harvester">مزیت‌های کلیدی Harvester</h3>

<p><strong>۱. Kubernetes-native بودن</strong>
Harvester روی بستر Kubernetes ساخته شده، نه اینکه صرفاً یک لایه‌ی مدیریتی روی
hypervisor باشه. این یعنی VM‌ها، containerها و زیرساخت شبکه همه از طریق Kubernetes
API مدیریت می‌شن و با ابزارهای GitOps مثل ArgoCD و Flux سازگاری کامل دارن.</p>

<p><strong>۲. یکپارچگی با Rancher</strong>
Harvester از روز اول با Rancher طراحی شده که کار می‌کنه. این یعنی می‌تونید مستقیماً
از داخل Harvester، کلاسترهای Kubernetes مدیریت‌شده (RKE2/K3s) بسازید — بدون نیاز
به ابزار جداگانه یا تنظیمات دستی اضافه.</p>

<p><strong>۳. Single pane of glass</strong>
با Proxmox معمولاً مجبورید برای مدیریت VM‌ها یک ابزار، برای کانتینرها ابزار دیگه‌ای،
و برای Kubernetes یک ابزار سوم داشته باشید. Harvester این سه رو در یک رابط یکپارچه
می‌کنه.</p>

<p><strong>۴. Longhorn به‌جای Ceph</strong>
Ceph قدرتمنده، اما راه‌اندازی و نگهداریش پیچیده‌ست و به cluster سه‌ node یا بیشتر
برای reliable بودن نیاز داره. Longhorn سبک‌تر، ساده‌تر، و برای محیط‌های کوچک‌تر
مناسب‌تره — در عین حال replication و snapshot رو هم پشتیبانی می‌کنه.</p>

<p><strong>۵. مسیر مهاجرت از VMware</strong>
ابزار <code class="language-bash highlighter-rouge">vm-import-controller</code> در Harvester امکان مهاجرت مستقیم از VMware vSphere رو
فراهم می‌کنه — این برای تیم‌هایی که دارن از VMware فرار می‌کنن یک مزیت عملی جدی‌ه.</p>

<blockquote>
  <p>⚠️ <strong>نکته مهم قبل از شروع:</strong>
Harvester حتی بدون ساختن کلاستر Kubernetes هم در حالت عادی منابع زیادی مصرف می‌کنه. از این نظر برای homelab با سخت‌افزار متوسط یا ضعیف — جایی که مصرف پایین برق و مدیریت بهینه منابع اهمیت زیادی داره — گزینه ایده‌آلی نیست. این رو در نظر بگیرید قبل از اینکه شروع کنید.</p>
</blockquote>

<h2 id="مرحله-اول-بوت-کردن-harvester-از-طریق-netboot">مرحله اول: بوت کردن Harvester از طریق Netboot</h2>

<p>برای بوت Harvester از طریق netboot دو کار باید بکنیم:</p>

<ol>
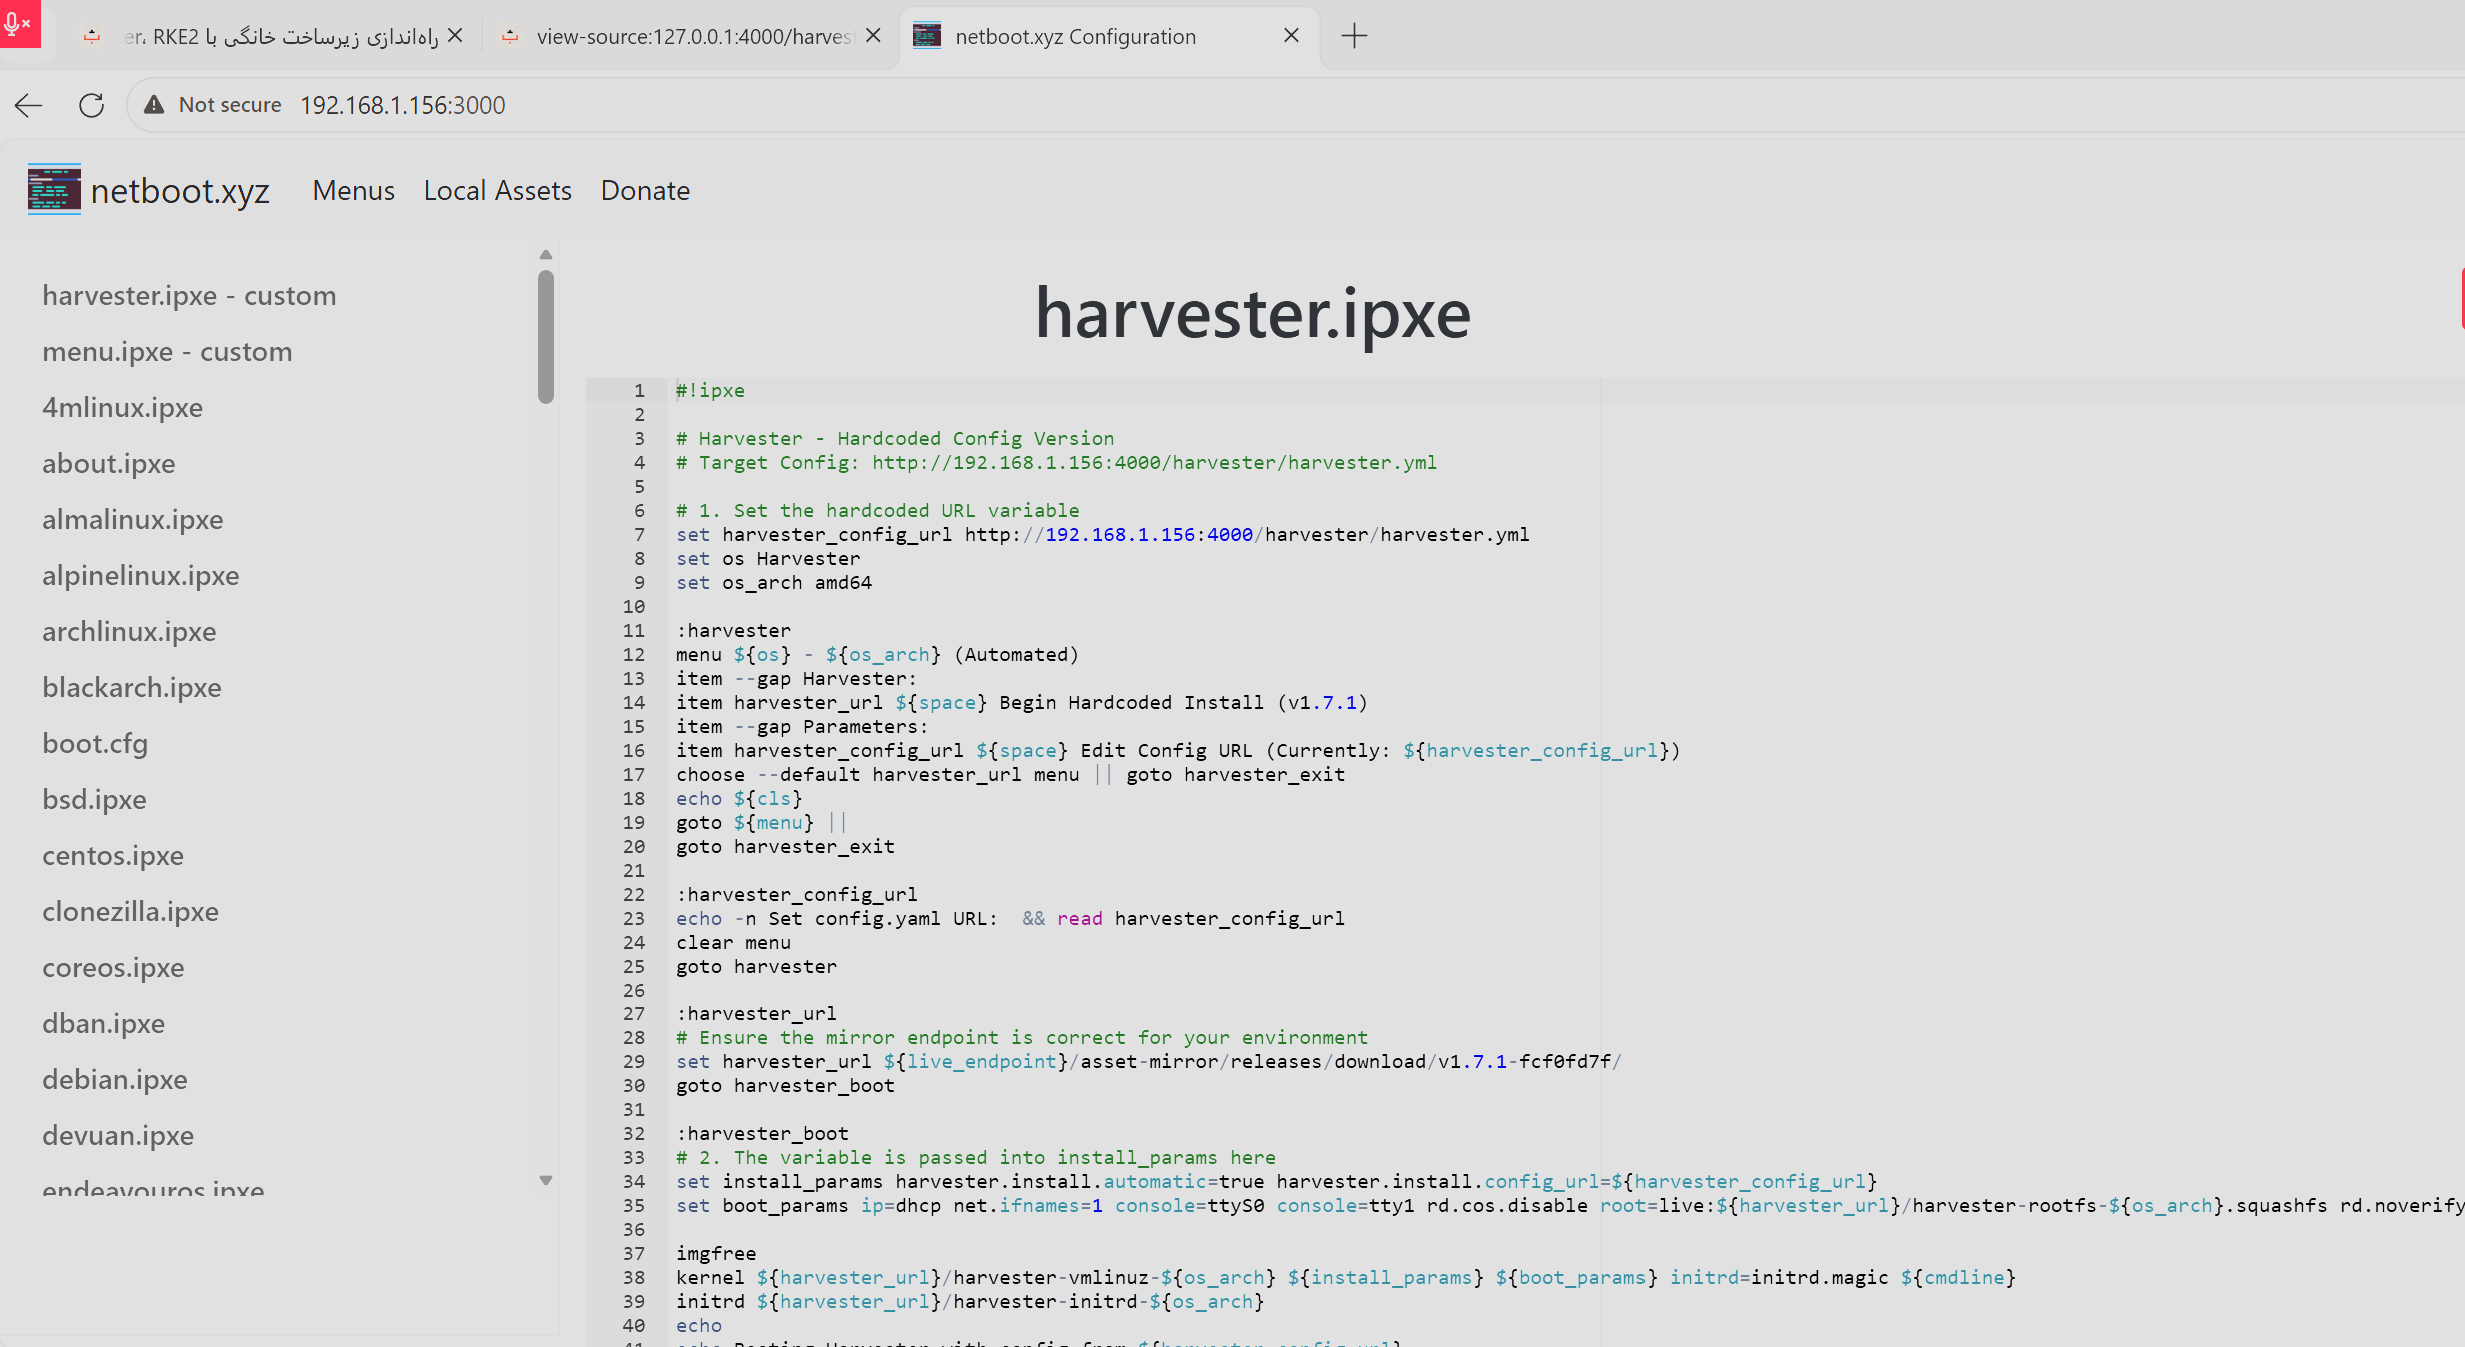
  <li>تغییر کانفیگ iPXE مخصوص Harvester
<img src="assets/article_images/harvester-homelab-setup/harvester-ipxe.png" alt="" title="Harvester IPXE" /></li>
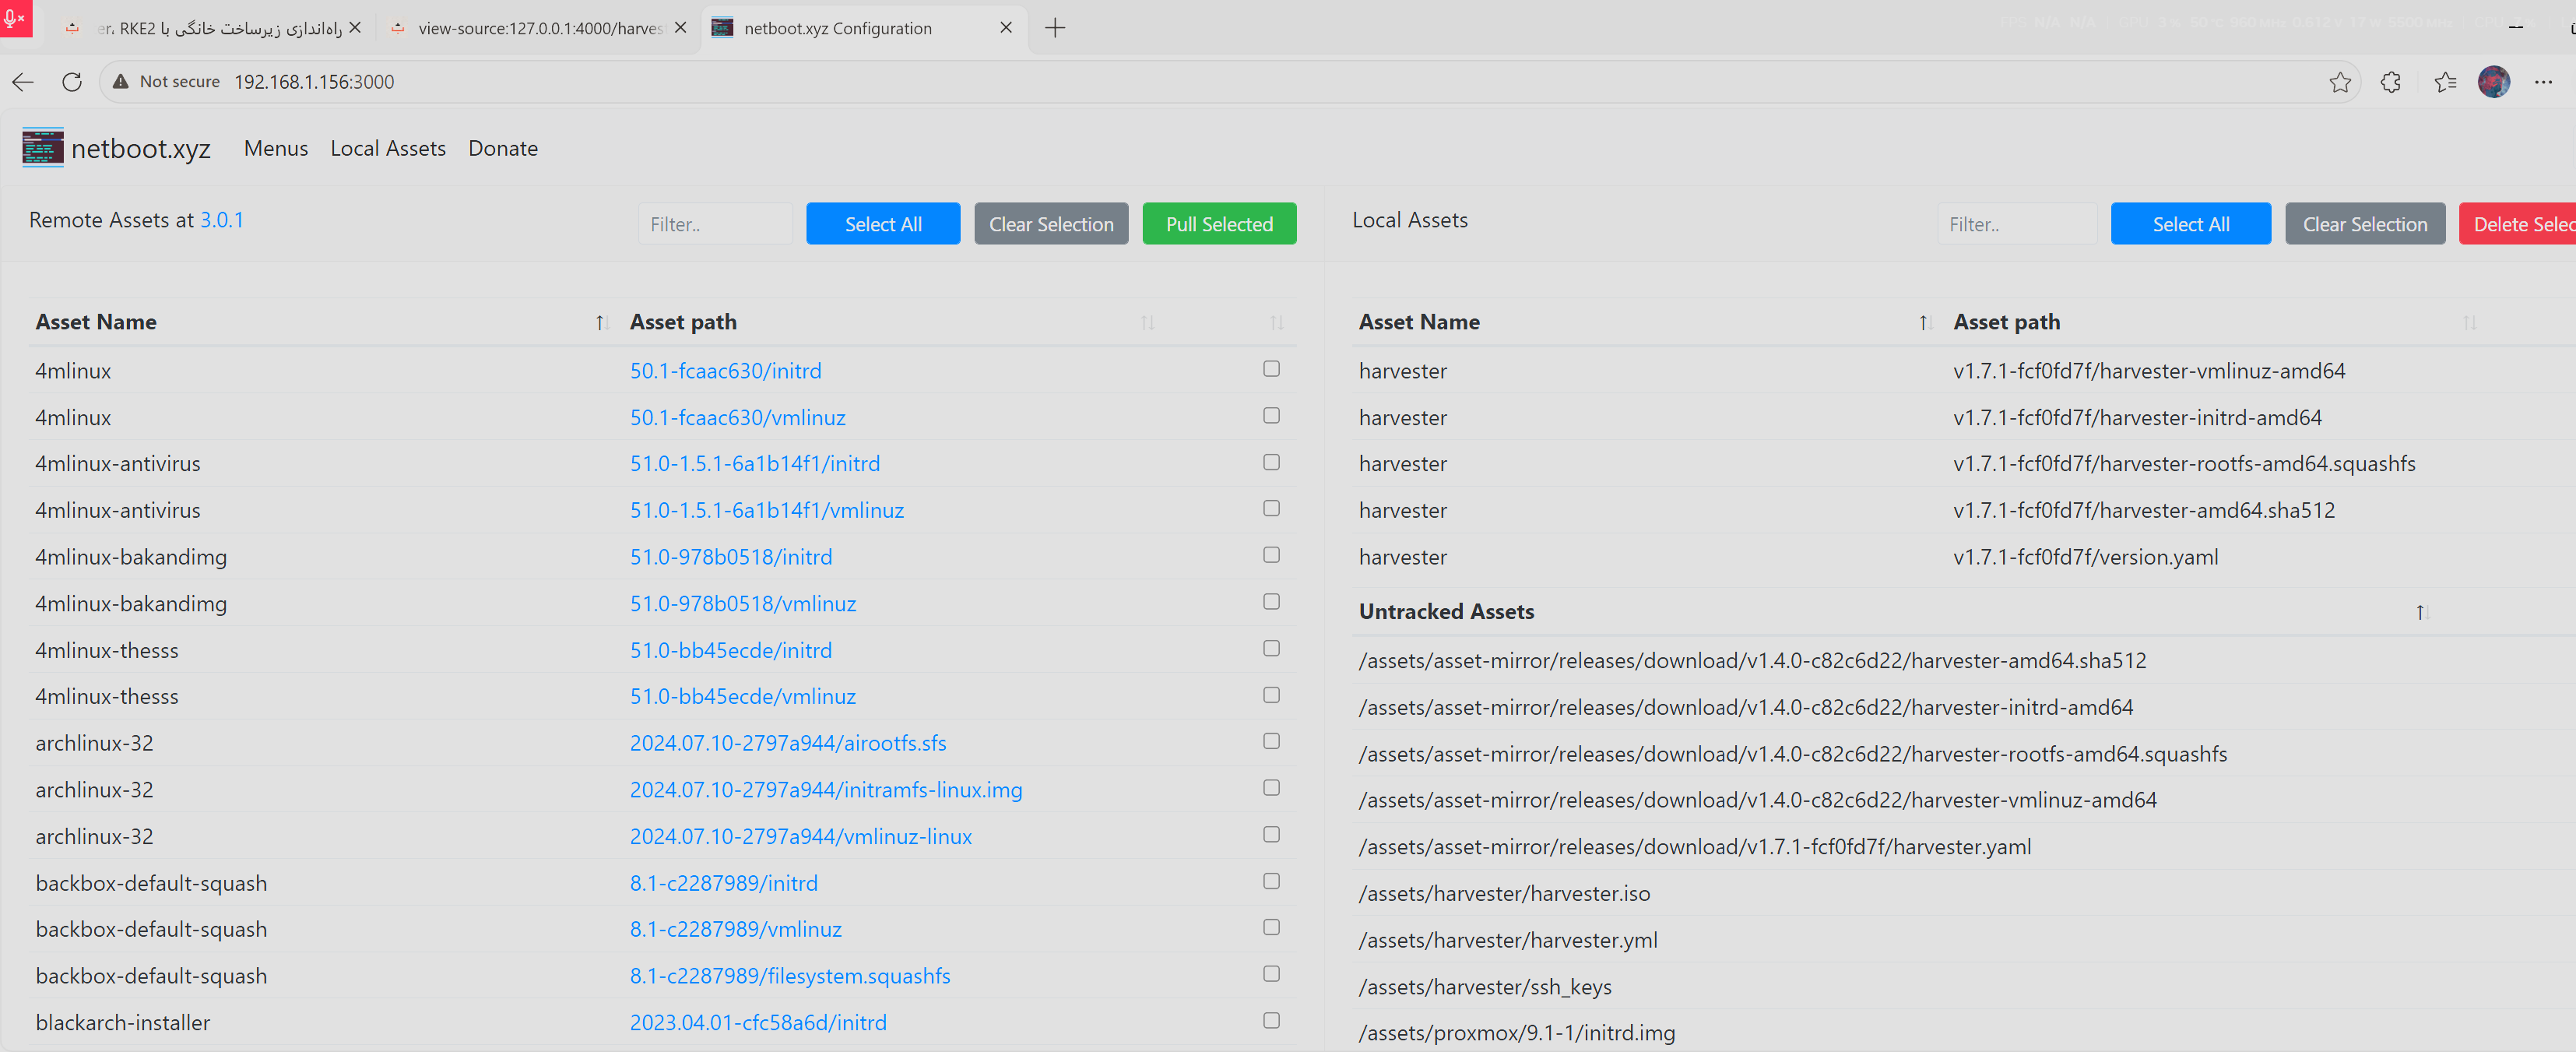
  <li>دانلود asset‌های پیش‌فرض موردنیاز
<img src="assets/article_images/harvester-homelab-setup/netboot-local-assets.png" alt="" title="Harvester netboot local assets" />
من از آخرین نسخه داکر netboot استفاده می‌کنم پس آخرین آپدیت‌ها رو هم دارم. کافیه این فایل‌ها رو از remote assets دانلود کنم:</li>
</ol>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="syntax"><code>/assets/asset-mirror/releases/download/v1.4.0-c82c6d22/harvester-amd64.sha512
/assets/asset-mirror/releases/download/v1.4.0-c82c6d22/harvester-initrd-amd64
/assets/asset-mirror/releases/download/v1.4.0-c82c6d22/harvester-rootfs-amd64.squashfs
/assets/asset-mirror/releases/download/v1.4.0-c82c6d22/harvester-vmlinuz-amd64
/assets/asset-mirror/releases/download/v1.7.1-fcf0fd7f/harvester.yaml
</code></pre></div></div>

<p>برای پیدا کردن آدرس ISO، وارد دایرکتوری asset‌ها میشیم و فایل <code class="language-bash highlighter-rouge">version.yaml</code> رو می‌خونیم:</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="syntax"><code><span class="nb">cd </span>assets/asset-mirror/releases/download/v1.7.1-fcf0fd7f
<span class="nb">cat </span>version.yaml
</code></pre></div></div>

<div class="language-yaml highlighter-rouge"><div class="highlight"><pre class="syntax"><code><span class="na">apiVersion</span><span class="pi">:</span> <span class="s">harvesterhci.io/v1beta1</span>
<span class="na">kind</span><span class="pi">:</span> <span class="s">Version</span>
<span class="na">metadata</span><span class="pi">:</span>
  <span class="na">name</span><span class="pi">:</span> <span class="s">v1.7.1</span>
  <span class="na">namespace</span><span class="pi">:</span> <span class="s">harvester-system</span>
<span class="na">spec</span><span class="pi">:</span>
  <span class="na">isoChecksum</span><span class="pi">:</span> <span class="s1">'</span><span class="s">381e6c6d09f4d5d1cb1b3813c1ad5dd8064618e5e5400b36fc26f05cea1425dd87659f93b7f34cd303d13289da7b34c5aa63ec935a8922c0e17ff733100ab361'</span>
  <span class="na">isoURL</span><span class="pi">:</span> <span class="s">https://releases.rancher.com/harvester/v1.7.1/harvester-v1.7.1-amd64.iso</span>
  <span class="na">releaseDate</span><span class="pi">:</span> <span class="s1">'</span><span class="s">20260209'</span>
</code></pre></div></div>

<p>حالا ISO رو دانلود می‌کنیم:</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="syntax"><code>wget https://releases.rancher.com/harvester/v1.7.1/harvester-v1.7.1-amd64.iso <span class="nb">.</span>
</code></pre></div></div>

<h2 id="مرحله-دوم-کانفیگ-ipxe-برای-harvester">مرحله دوم: کانفیگ iPXE برای Harvester</h2>

<p>الان وقتشه که کانفیگ iPXE Harvester رو عوض کنیم. فایل زیر رو ویرایش کنید:</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="syntax"><code><span class="c">#!ipxe</span>

<span class="c"># Harvester - Hardcoded Config Version</span>
<span class="c"># Target Config: http://192.168.1.156:4000/harvester/harvester.yml</span>

<span class="nb">set </span>harvester_config_url http://192.168.1.156:4000/harvester/harvester.yml
<span class="nb">set </span>os Harvester
<span class="nb">set </span>os_arch amd64

:harvester
menu <span class="k">${</span><span class="nv">os</span><span class="k">}</span> - <span class="k">${</span><span class="nv">os_arch</span><span class="k">}</span> <span class="o">(</span>Automated<span class="o">)</span>
item <span class="nt">--gap</span> Harvester:
item harvester_url <span class="k">${</span><span class="nv">space</span><span class="k">}</span> Begin Hardcoded Install <span class="o">(</span>v1.7.1<span class="o">)</span>
item <span class="nt">--gap</span> Parameters:
item harvester_config_url <span class="k">${</span><span class="nv">space</span><span class="k">}</span> Edit Config URL <span class="o">(</span>Currently: <span class="k">${</span><span class="nv">harvester_config_url</span><span class="k">}</span><span class="o">)</span>
choose <span class="nt">--default</span> harvester_url menu <span class="o">||</span> goto harvester_exit
<span class="nb">echo</span> <span class="k">${</span><span class="nv">cls</span><span class="k">}</span>
goto <span class="k">${</span><span class="nv">menu</span><span class="k">}</span> <span class="o">||</span>
goto harvester_exit

:harvester_config_url
<span class="nb">echo</span> <span class="nt">-n</span> Set config.yaml URL:  <span class="o">&amp;&amp;</span> <span class="nb">read </span>harvester_config_url
clear menu
goto harvester

:harvester_url
<span class="nb">set </span>harvester_url <span class="k">${</span><span class="nv">live_endpoint</span><span class="k">}</span>/asset-mirror/releases/download/v1.7.1-fcf0fd7f/
goto harvester_boot

:harvester_boot
<span class="nb">set </span>install_params harvester.install.automatic<span class="o">=</span><span class="nb">true </span>harvester.install.config_url<span class="o">=</span><span class="k">${</span><span class="nv">harvester_config_url</span><span class="k">}</span>
<span class="nb">set </span>boot_params <span class="nv">ip</span><span class="o">=</span>dhcp net.ifnames<span class="o">=</span>1 <span class="nv">console</span><span class="o">=</span>ttyS0 <span class="nv">console</span><span class="o">=</span>tty1 rd.cos.disable <span class="nv">root</span><span class="o">=</span>live:<span class="k">${</span><span class="nv">harvester_url</span><span class="k">}</span>/harvester-rootfs-<span class="k">${</span><span class="nv">os_arch</span><span class="k">}</span>.squashfs rd.noverifyssl

imgfree
kernel <span class="k">${</span><span class="nv">harvester_url</span><span class="k">}</span>/harvester-vmlinuz-<span class="k">${</span><span class="nv">os_arch</span><span class="k">}</span> <span class="k">${</span><span class="nv">install_params</span><span class="k">}</span> <span class="k">${</span><span class="nv">boot_params</span><span class="k">}</span> <span class="nv">initrd</span><span class="o">=</span>initrd.magic <span class="k">${</span><span class="nv">cmdline</span><span class="k">}</span>
initrd <span class="k">${</span><span class="nv">harvester_url</span><span class="k">}</span>/harvester-initrd-<span class="k">${</span><span class="nv">os_arch</span><span class="k">}</span>
<span class="nb">echo
echo </span>Booting Harvester with config from <span class="k">${</span><span class="nv">harvester_config_url</span><span class="k">}</span>
boot

:harvester_exit
clear menu
<span class="nb">exit </span>0
</code></pre></div></div>

<blockquote>
  <p><strong>نکته:</strong> پارامتری که اینجا تغییر دادم <code class="language-bash highlighter-rouge">harvester_config_url</code> هست. از اونجایی که netboot رو روی آدرس <code class="language-bash highlighter-rouge">192.168.1.156</code> اجرا می‌کنم، موقع نصب هم فایل ISO و هم <code class="language-bash highlighter-rouge">harvester.yml</code> رو از همین آدرس می‌گیره.</p>
</blockquote>

<h2 id="مرحله-سوم-ساختار-دایرکتوری-و-فایلهای-موردنیاز">مرحله سوم: ساختار دایرکتوری و فایل‌های موردنیاز</h2>

<p>توی دایرکتوری <code class="language-bash highlighter-rouge">assets</code> یه دایرکتوری جدید به اسم <code class="language-bash highlighter-rouge">harvester</code> می‌سازیم:</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="syntax"><code>├── ./harvester
│   ├── ./harvester/harvester.iso
│   ├── ./harvester/harvester.yml
│   └── ./harvester/ssh_keys
</code></pre></div></div>

<p>فایل ISO رو به این دایرکتوری منتقل می‌کنیم و اسمش رو به <code class="language-bash highlighter-rouge">harvester.iso</code> تغییر می‌دیم.</p>

<h2 id="مرحله-چهارم-کانفیگ-نصب-harvester">مرحله چهارم: کانفیگ نصب Harvester</h2>

<p>حالا فایل <code class="language-bash highlighter-rouge">harvester.yml</code> رو می‌سازیم. این فایل تمام تنظیمات خودکار نصب رو داره، از جمله اطلاعات شبکه، دیسک، VIP و رمز عبور:</p>

<div class="language-yaml highlighter-rouge"><div class="highlight"><pre class="syntax"><code><span class="na">schemeversion</span><span class="pi">:</span> <span class="m">1</span>
<span class="na">serverurl</span><span class="pi">:</span> <span class="s2">"</span><span class="s">"</span>
<span class="na">token</span><span class="pi">:</span> <span class="s">xxxx</span> <span class="c1"># این توکن رو عوض کنید</span>
<span class="na">sans</span><span class="pi">:</span> <span class="pi">[]</span>
<span class="na">os</span><span class="pi">:</span>
  <span class="na">afterinstallchrootcommands</span><span class="pi">:</span> <span class="pi">[]</span>
  <span class="na">sshauthorizedkeys</span><span class="pi">:</span>
    <span class="pi">-</span> <span class="c1"># کلید عمومی SSH خودتون رو اینجا بزارید</span>
  <span class="na">hostname</span><span class="pi">:</span> <span class="s">harvester</span>
  <span class="na">modules</span><span class="pi">:</span>
    <span class="pi">-</span> <span class="s">kvm</span>
    <span class="pi">-</span> <span class="s">vhost_net</span>
  <span class="na">sysctls</span><span class="pi">:</span> <span class="pi">{}</span>
  <span class="na">ntpservers</span><span class="pi">:</span>
    <span class="pi">-</span> <span class="s">0.suse.pool.ntp.org</span>
    <span class="pi">-</span> <span class="s">1.suse.pool.ntp.org</span>
  <span class="na">dnsnameservers</span><span class="pi">:</span> <span class="pi">[]</span>
  <span class="na">password</span><span class="pi">:</span> <span class="c1"># خروجی دستور mkpasswd -m sha-512 رو اینجا بزارید</span>
  <span class="na">environment</span><span class="pi">:</span> <span class="pi">{}</span>
  <span class="na">labels</span><span class="pi">:</span> <span class="pi">{}</span>
  <span class="na">sshd</span><span class="pi">:</span>
    <span class="na">sftp</span><span class="pi">:</span> <span class="no">false</span>
  <span class="na">persistentstatepaths</span><span class="pi">:</span> <span class="pi">[]</span>
  <span class="na">externalstorage</span><span class="pi">:</span>
    <span class="na">enabled</span><span class="pi">:</span> <span class="no">false</span>
    <span class="na">multipathconfig</span><span class="pi">:</span> <span class="no">null</span>
  <span class="na">additionalkernelarguments</span><span class="pi">:</span> <span class="s2">"</span><span class="s">"</span>
<span class="na">install</span><span class="pi">:</span>
  <span class="na">automatic</span><span class="pi">:</span> <span class="no">true</span>
  <span class="na">skipchecks</span><span class="pi">:</span> <span class="no">true</span>
  <span class="na">mode</span><span class="pi">:</span> <span class="s">create</span>
  <span class="na">managementinterface</span><span class="pi">:</span>
    <span class="na">interfaces</span><span class="pi">:</span>
      <span class="pi">-</span> <span class="na">name</span><span class="pi">:</span> <span class="s">enp0s31f6</span>    <span class="c1"># اینترفیس شبکه خودتون رو بنویسید</span>
        <span class="na">hwaddr</span><span class="pi">:</span> <span class="s">e8:80:xxxxx</span> <span class="c1"># مک آدرس کارت شبکه‌تون رو بنویسید</span>
    <span class="na">method</span><span class="pi">:</span> <span class="s">dhcp</span>  <span class="c1"># اگه IP استاتیک دارید، این رو به static تغییر بدید</span>
    <span class="na">ip</span><span class="pi">:</span> <span class="s2">"</span><span class="s">"</span>
    <span class="na">subnetmask</span><span class="pi">:</span> <span class="s2">"</span><span class="s">"</span>
    <span class="na">gateway</span><span class="pi">:</span> <span class="s2">"</span><span class="s">"</span>
    <span class="na">defaultroute</span><span class="pi">:</span> <span class="no">true</span>
    <span class="na">bondoptions</span><span class="pi">:</span>
      <span class="na">miimon</span><span class="pi">:</span> <span class="s2">"</span><span class="s">100"</span>
      <span class="na">mode</span><span class="pi">:</span> <span class="s">active-backup</span>
    <span class="na">mtu</span><span class="pi">:</span> <span class="m">0</span>
    <span class="na">vlanid</span><span class="pi">:</span> <span class="m">0</span>
  <span class="na">vip</span><span class="pi">:</span> <span class="s">192.168.1.157</span>          <span class="c1"># IP مدیریتی Harvester در شبکه شما</span>
  <span class="na">viphwaddr</span><span class="pi">:</span> <span class="s2">"</span><span class="s">"</span>
  <span class="na">vipmode</span><span class="pi">:</span> <span class="s">static</span>
  <span class="na">clusterdns</span><span class="pi">:</span> <span class="s2">"</span><span class="s">"</span>
  <span class="na">clusterpodcidr</span><span class="pi">:</span> <span class="s2">"</span><span class="s">"</span>
  <span class="na">clusterservicecidr</span><span class="pi">:</span> <span class="s2">"</span><span class="s">"</span>
  <span class="na">forceefi</span><span class="pi">:</span> <span class="no">false</span>
  <span class="na">device</span><span class="pi">:</span> <span class="s">/dev/nvme0n1</span>
  <span class="na">configurl</span><span class="pi">:</span> <span class="s">http://192.168.1.156:4000/harvester/harvester.yml</span>  <span class="c1"># آدرس netboot سرور شما</span>
  <span class="na">isourl</span><span class="pi">:</span> <span class="s">http://192.168.1.156:4000/harvester/harvester.iso</span>     <span class="c1"># آدرس netboot سرور شما</span>
  <span class="na">silent</span><span class="pi">:</span> <span class="no">false</span>
  <span class="na">poweroff</span><span class="pi">:</span> <span class="no">false</span>
  <span class="na">noformat</span><span class="pi">:</span> <span class="no">false</span>
  <span class="na">debug</span><span class="pi">:</span> <span class="no">false</span>
  <span class="na">tty</span><span class="pi">:</span> <span class="s">ttyS0</span>
  <span class="na">forcegpt</span><span class="pi">:</span> <span class="no">true</span>
  <span class="na">role</span><span class="pi">:</span> <span class="s">default</span>
  <span class="na">withnetimages</span><span class="pi">:</span> <span class="no">false</span>
  <span class="na">wipealldisks</span><span class="pi">:</span> <span class="no">false</span>
  <span class="na">wipediskslist</span><span class="pi">:</span> <span class="pi">[]</span>
  <span class="na">forcembr</span><span class="pi">:</span> <span class="no">false</span>
  <span class="na">datadisk</span><span class="pi">:</span> <span class="s2">"</span><span class="s">"</span>
  <span class="na">webhooks</span><span class="pi">:</span> <span class="pi">[]</span>
  <span class="na">addons</span><span class="pi">:</span> <span class="pi">{}</span>
  <span class="na">harvester</span><span class="pi">:</span>
    <span class="na">storageclass</span><span class="pi">:</span>
      <span class="na">replicacount</span><span class="pi">:</span> <span class="m">1</span>  <span class="c1"># چون single node هستیم؛ در کلاستر چندنوده این رو روی 3 بزارید</span>
    <span class="na">longhorn</span><span class="pi">:</span>
      <span class="na">defaultsettings</span><span class="pi">:</span>
        <span class="na">guaranteedenginemanagercpu</span><span class="pi">:</span> <span class="no">null</span>
        <span class="na">guaranteedreplicamanagercpu</span><span class="pi">:</span> <span class="no">null</span>
        <span class="na">guaranteedinstancemanagercpu</span><span class="pi">:</span> <span class="no">null</span>
        <span class="na">storagereservedpercentagefordefaultdisk</span><span class="pi">:</span> <span class="m">0</span>
    <span class="na">enablegocoverdir</span><span class="pi">:</span> <span class="no">false</span>
  <span class="na">rawdiskimagepath</span><span class="pi">:</span> <span class="s2">"</span><span class="s">"</span>
  <span class="na">persistentpartitionsize</span><span class="pi">:</span> <span class="s">286Gi</span>
<span class="na">runtimeversion</span><span class="pi">:</span> <span class="s">v1.34.3+rke2r3</span>
<span class="na">rancherversion</span><span class="pi">:</span> <span class="s">v2.13.1</span>
<span class="na">harvesterchartversion</span><span class="pi">:</span> <span class="s">1.7.1</span>
<span class="na">monitoringchartversion</span><span class="pi">:</span> <span class="s">107.1.0+up69.8.2-rancher.15</span>
<span class="na">systemsettings</span><span class="pi">:</span>
  <span class="na">ntp-servers</span><span class="pi">:</span> <span class="s1">'</span><span class="s">{"ntpServers":["0.suse.pool.ntp.org","1.suse.pool.ntp.org"]}'</span>
<span class="na">loggingchartversion</span><span class="pi">:</span> <span class="s">107.0.1+up4.10.0-rancher.10</span>
<span class="na">kubeovnoperatorchartversion</span><span class="pi">:</span> <span class="s">1.14.10</span>
</code></pre></div></div>

<h2 id="مرحله-پنجم-بوت-و-تأیید-نصب">مرحله پنجم: بوت و تأیید نصب</h2>

<p>مراحل بوت رو پشت سر می‌زاریم. اگه همه چیز درست پیش رفته باشه، کلاستر تک‌نود Harvester ما می‌آد بالا.</p>

<p>یوزر پیش‌فرض OS هاروستر <code class="language-bash highlighter-rouge">rancher</code> هست و از طریق اون به کلاستر وصل میشیم:</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="syntax"><code>ssh rancher@192.168.1.105
</code></pre></div></div>

<p>برای تأیید وضعیت، <code class="language-bash highlighter-rouge">screendump 1</code> رو اجرا کنید. باید یه چنین خروجی ببینید:</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="syntax"><code>┌─ Harvester Cluster ────────────────────────────────────────────────────────┐
│ <span class="k">*</span> Management URL:                                                           │
│   https://192.168.1.157                                                     │
│                                                                             │
│ <span class="k">*</span> Status: Ready                                                             │
└─────────────────────────────────────────────────────────────────────────────┘
┌─ Node ─────────────────────────────────────────────────────────────────────┐
│ <span class="k">*</span> Hostname: harvester                                                       │
│ <span class="k">*</span> IP Address: 192.168.1.105                                                 │
│                                                                             │
│ <span class="k">*</span> Status: Ready                                                             │
└─────────────────────────────────────────────────────────────────────────────┘
</code></pre></div></div>

<h2 id="مرحله-ششم-تنظیمات-شبکه-در-harvester">مرحله ششم: تنظیمات شبکه در Harvester</h2>

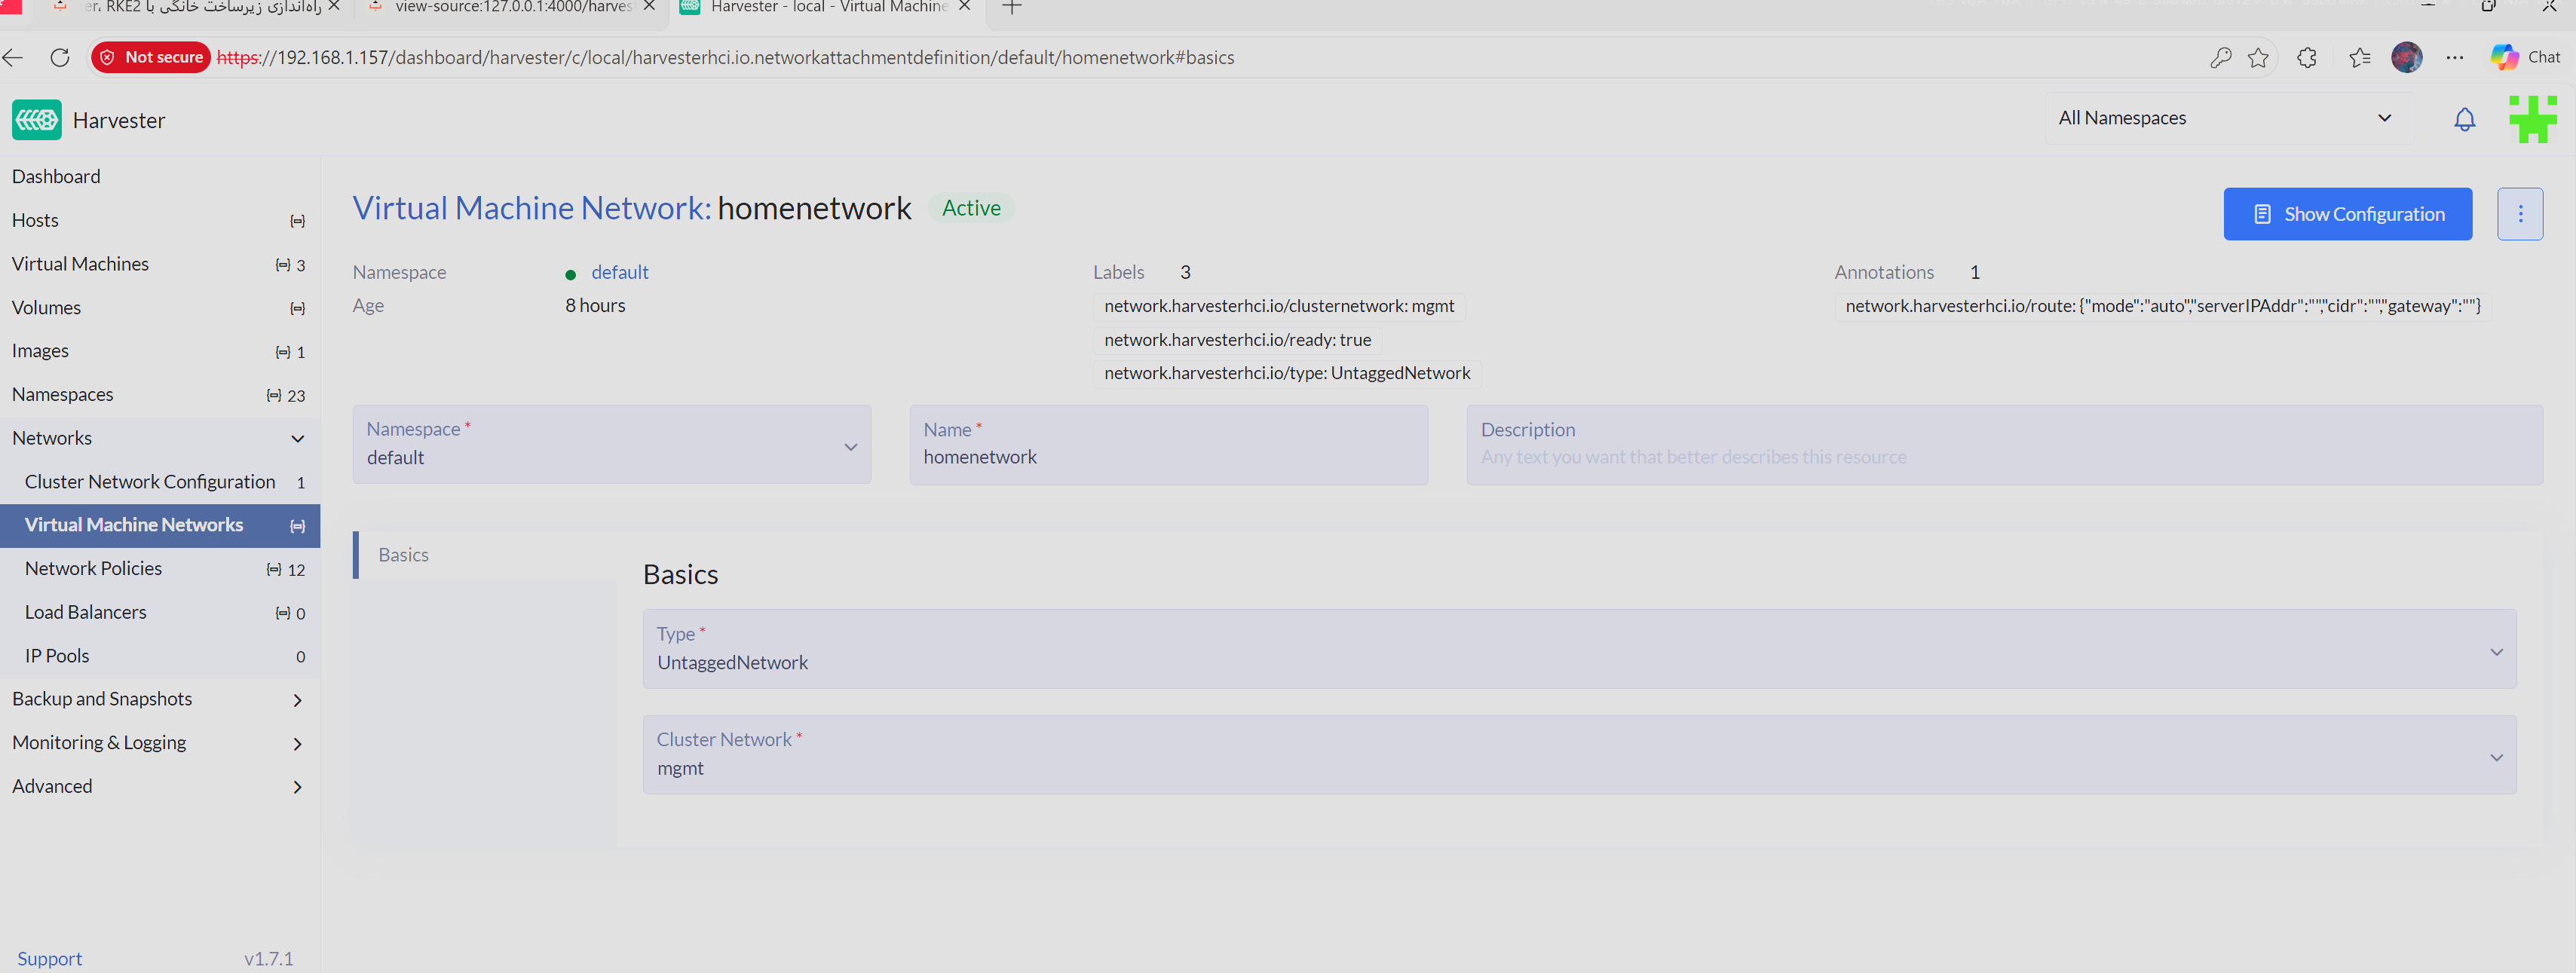
<p><img src="assets/article_images/harvester-homelab-setup/harvester-homenetwork.png" alt="" title="Harvester Home Network" /></p>

<p>چون من توی شبکه خانگیم VLAN ندارم، گزینه <strong>Untagged Network</strong> رو انتخاب می‌کنم. این باعث میشه که VM‌هایی که می‌سازیم بتونن از طریق bridge از DHCP آدرس IP بگیرن.</p>

<h2 id="مرحله-هفتم-آپلود-ایمیج-برای-vm">مرحله هفتم: آپلود ایمیج برای VM</h2>

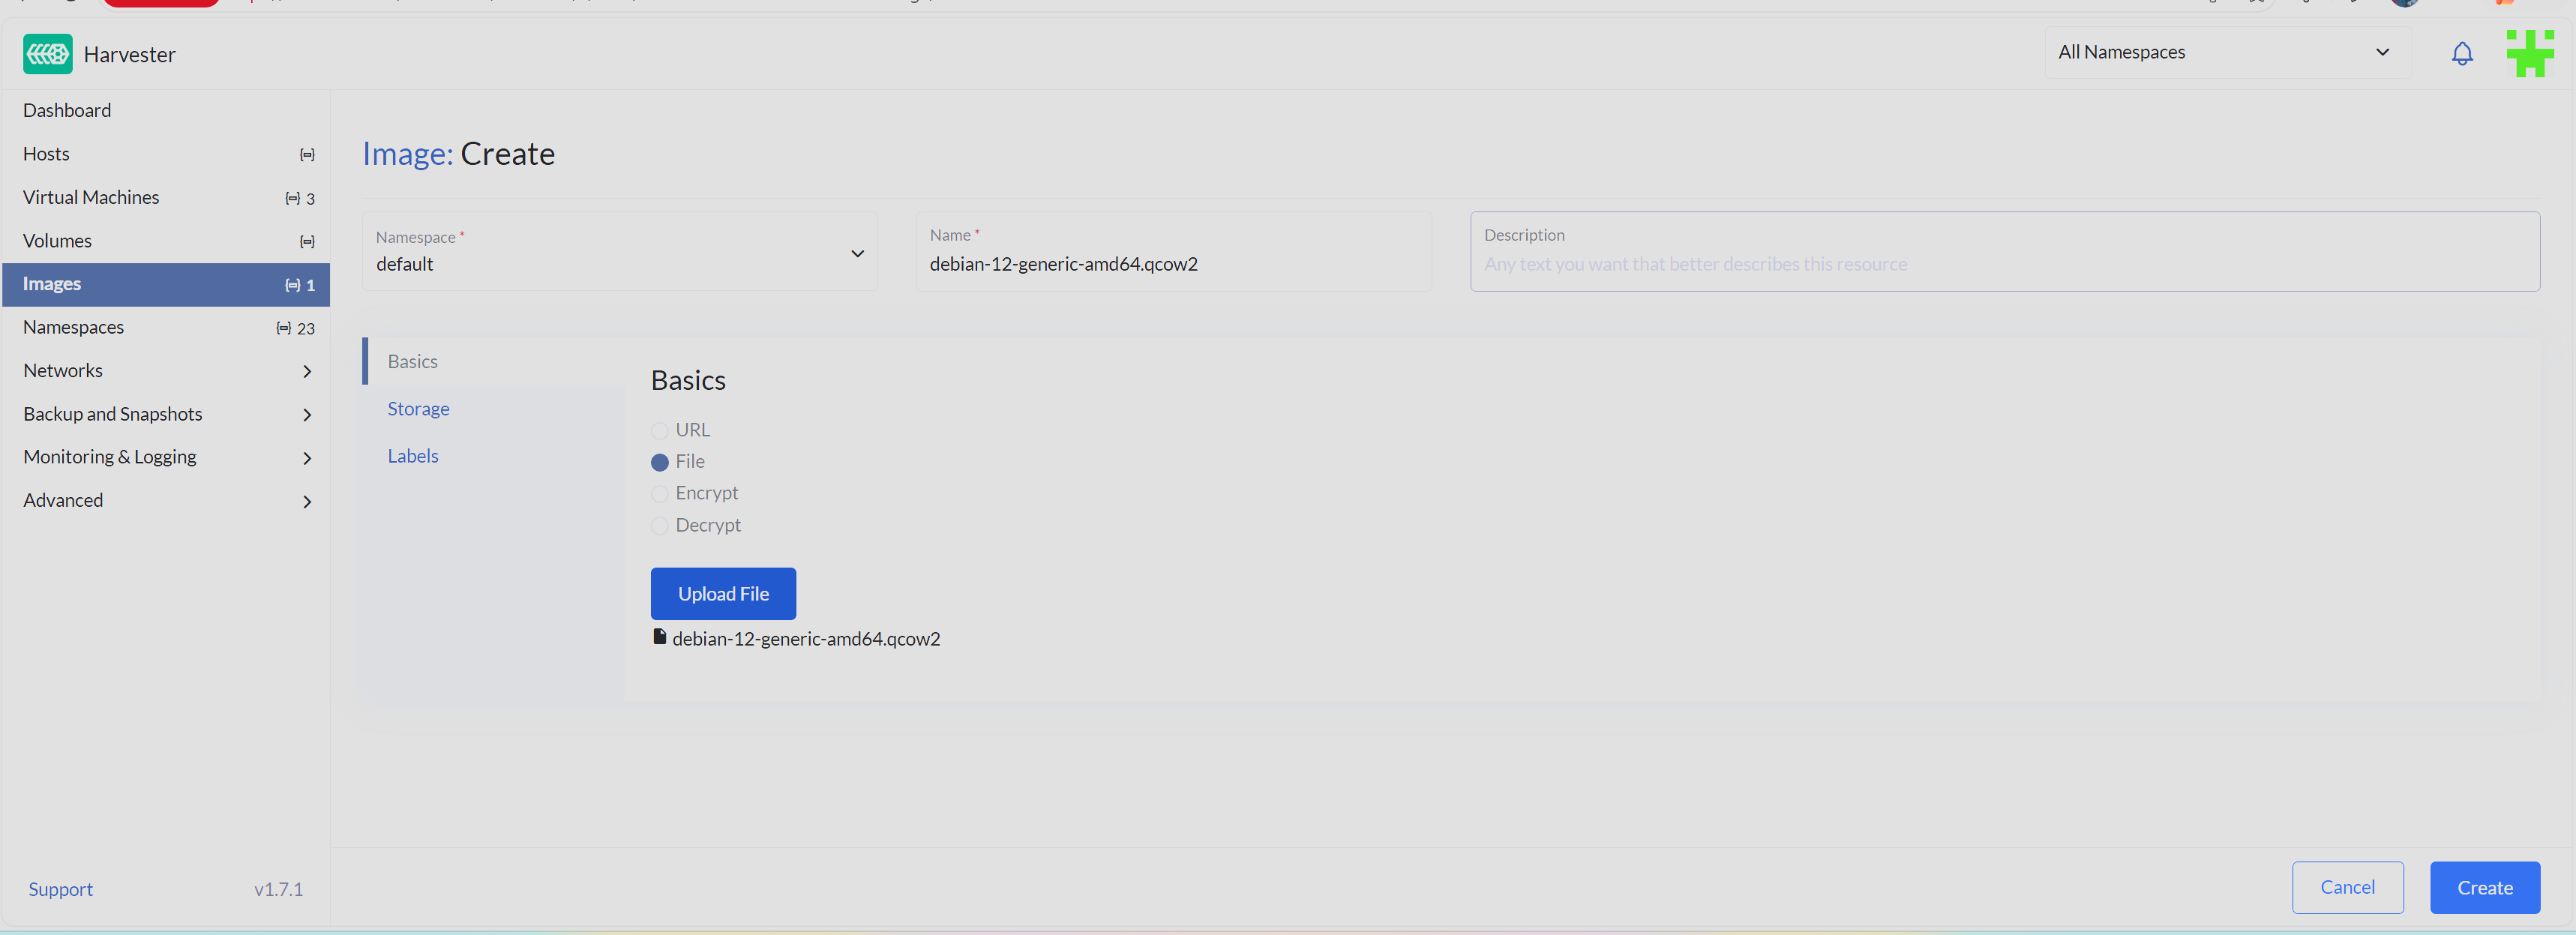
<p>برای ساختن VM نیاز داریم به یه ایمیج <code class="language-bash highlighter-rouge">qcow2</code> با پشتیبانی از cloud-init. من از Debian Bookworm استفاده می‌کنم ولی شما می‌تونید هر ایمیج cloud-init دیگه‌ای که باهاش راحت‌تر هستید رو انتخاب کنید:</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="syntax"><code>wget https://laotzu.ftp.acc.umu.se/images/cloud/bookworm/latest/debian-12-generic-amd64.qcow2
</code></pre></div></div>

<p>بعد از دانلود، این ایمیج رو از تب <strong>Images</strong> در Harvester UI به صورت file آپلود کنید.</p>

<p><img src="assets/article_images/harvester-homelab-setup/harvester-debian-image.png" alt="" title="Harvester DEbian Image Upload" /></p>

<h2 id="مرحله-هشتم-ساختن-rancher-server-vm">مرحله هشتم: ساختن Rancher Server VM</h2>

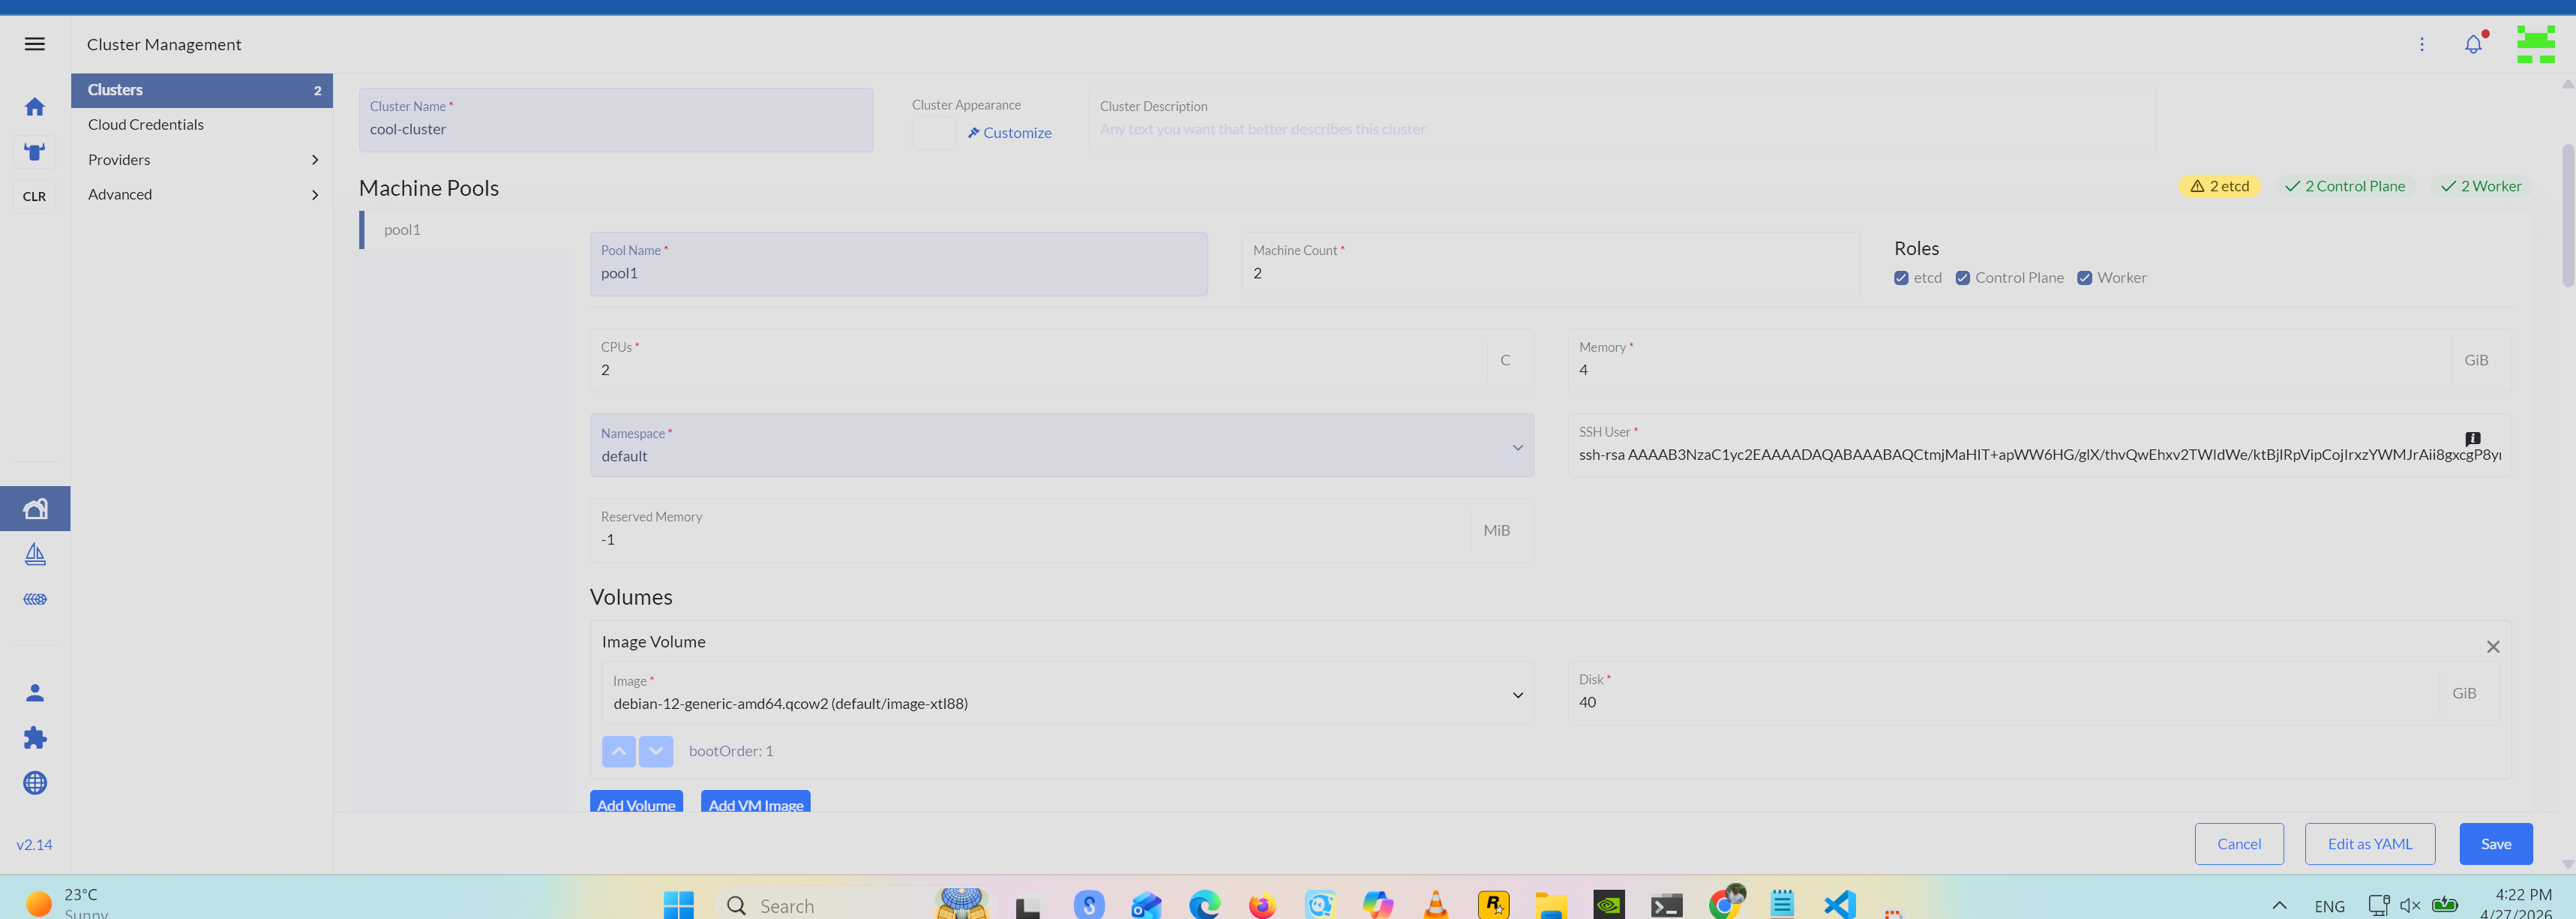
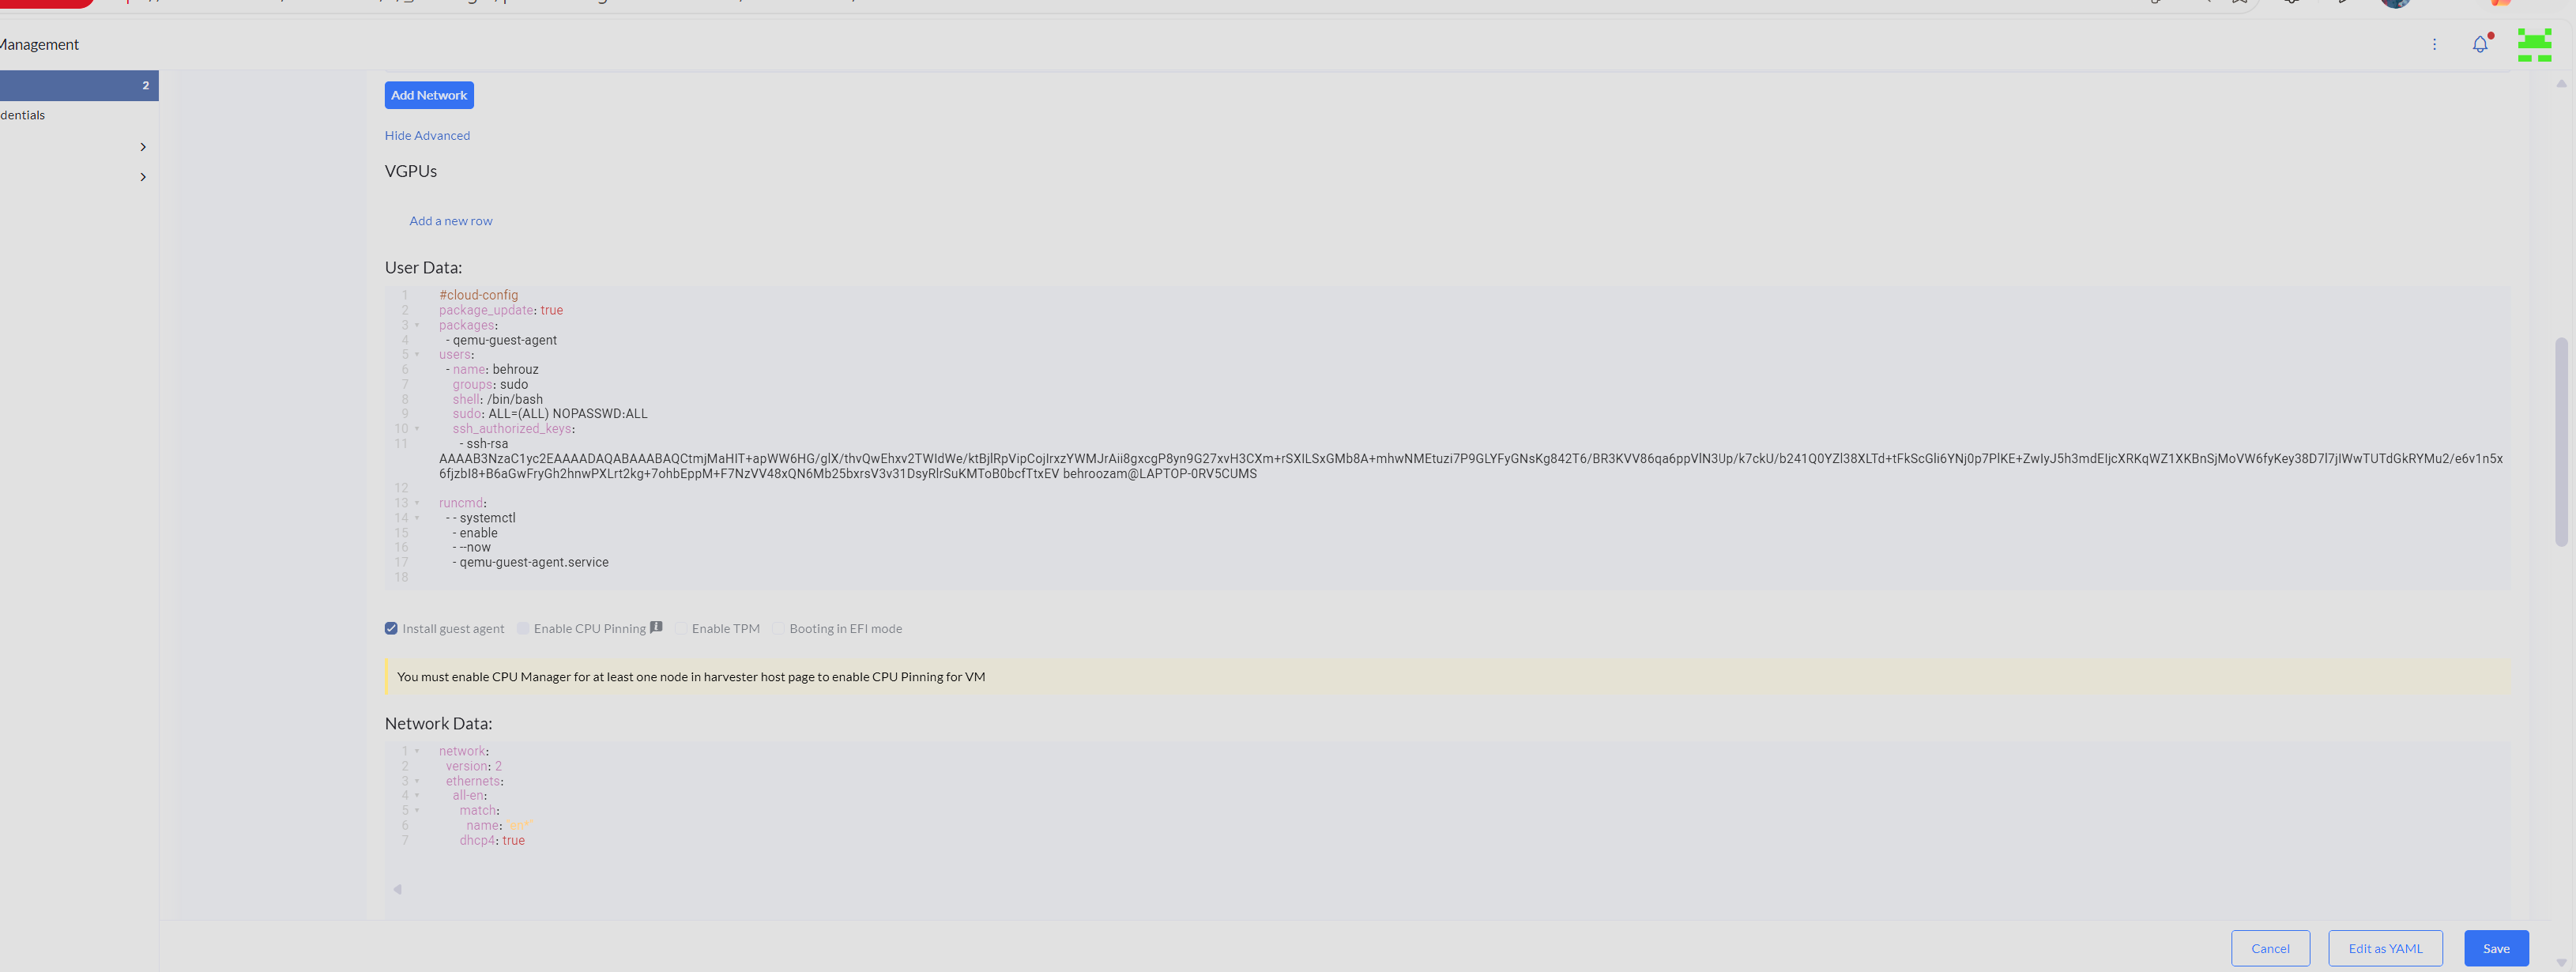
<p>الان یه VM برای Rancher Server می‌سازیم. برای disk size مقدار <strong>50 گیگابایت</strong> کافیه. تنظیمات cloud-init رو در قسمت <strong>Advanced Options</strong> وارد کنید:</p>

<p><strong>User Data:</strong></p>

<div class="language-yaml highlighter-rouge"><div class="highlight"><pre class="syntax"><code><span class="c1">#cloud-config</span>
<span class="na">package_update</span><span class="pi">:</span> <span class="no">true</span>
<span class="na">packages</span><span class="pi">:</span>
  <span class="pi">-</span> <span class="s">qemu-guest-agent</span>
<span class="na">users</span><span class="pi">:</span>
  <span class="pi">-</span> <span class="na">name</span><span class="pi">:</span> <span class="s">behrouz</span>
    <span class="na">groups</span><span class="pi">:</span> <span class="s">sudo</span>
    <span class="na">shell</span><span class="pi">:</span> <span class="s">/bin/bash</span>
    <span class="na">sudo</span><span class="pi">:</span> <span class="s">ALL=(ALL) NOPASSWD:ALL</span>
    <span class="na">ssh_authorized_keys</span><span class="pi">:</span>
      <span class="pi">-</span> <span class="s">your-ssh-public-key-here</span>

<span class="na">runcmd</span><span class="pi">:</span>
  <span class="pi">-</span> <span class="pi">-</span> <span class="s">systemctl</span>
    <span class="pi">-</span> <span class="s">enable</span>
    <span class="pi">-</span> <span class="s">--now</span>
    <span class="pi">-</span> <span class="s">qemu-guest-agent.service</span>
<span class="na">ssh_authorized_keys</span><span class="pi">:</span>
  <span class="pi">-</span> <span class="s">ssh-rsa YOUR_KEY_HERE</span>
</code></pre></div></div>

<blockquote>
  <p><strong>توصیه:</strong> اگه با ساختار و عملکرد cloud-init آشنایی ندارید، قبل از ادامه وقت بزارید و درموردش مطالعه کنید. این ابزار خیلی قدرتمنده و درک درستش بعداً خیلی کمکتون می‌کنه.</p>
</blockquote>

<p><strong>Network Config:</strong></p>

<div class="language-yaml highlighter-rouge"><div class="highlight"><pre class="syntax"><code><span class="na">network</span><span class="pi">:</span>
  <span class="na">version</span><span class="pi">:</span> <span class="m">2</span>
  <span class="na">ethernets</span><span class="pi">:</span>
    <span class="na">all-en</span><span class="pi">:</span>
      <span class="na">match</span><span class="pi">:</span>
        <span class="na">name</span><span class="pi">:</span> <span class="s2">"</span><span class="s">en*"</span>
      <span class="na">dhcp4</span><span class="pi">:</span> <span class="no">true</span>
</code></pre></div></div>

<blockquote>
  <p><strong>توصیه:</strong> این تنظیمات رو به صورت <strong>template</strong> ذخیره کنید تا بعداً هم توی ساختن کلاستر از همشون استفاده کنیم.</p>
</blockquote>

<h2 id="مرحله-نهم-نصب-rancher-روی-vm">مرحله نهم: نصب Rancher روی VM</h2>

<p>به <code class="language-bash highlighter-rouge">rancher-server</code> وصل میشیم، Docker نصب می‌کنیم و Rancher رو اجرا می‌کنیم:</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="syntax"><code>ssh behrouz@192.168.1.112

<span class="c"># نصب Docker</span>
curl <span class="nt">-fsSL</span> https://get.docker.com <span class="nt">-o</span> get-docker.sh <span class="o">&amp;&amp;</span> sh get-docker.sh
<span class="nb">sudo </span>usermod <span class="nt">-aG</span> docker behrouz
<span class="nb">exit</span>

<span class="c"># اتصال مجدد و اجرای Rancher</span>
ssh behrouz@192.168.1.112
docker run <span class="nt">-d</span> <span class="nt">--restart</span><span class="o">=</span>unless-stopped <span class="se">\</span>
  <span class="nt">-p</span> 80:80 <span class="nt">-p</span> 443:443 <span class="se">\</span>
  <span class="nt">--privileged</span> rancher/rancher:v2.14.0
</code></pre></div></div>

<blockquote>
  <p><strong>توجه:</strong> این روش یعنی Rancher رو به صورت <strong>single node</strong> اجرا می‌کنیم که برای homelab و محیط آموزشی مناسبه. ولی برای محیط production همیشه سعی کنید حداقل <strong>3 نود</strong> در ماشین‌های جداگانه داشته باشید.</p>
</blockquote>

<p>چند دقیقه صبر کنید تا نصب تموم بشه، بعد bootstrap password رو بگیرید:</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="syntax"><code><span class="c"># ID کانتینر Rancher رو پیدا کنید</span>
docker ps

<span class="c"># لاگ رو بخونید و bootstrap password رو بیرون بکشید</span>
docker logs 5b6933b359a0 2&gt;&amp;1 | <span class="nb">grep</span> <span class="s2">"Bootstrap Password:"</span>
</code></pre></div></div>

<p>با این پسورد وارد Rancher UI بشید و <strong>Harvester UI Plugin</strong> رو از قسمت Extensions نصب کنید. اگه نصب پلاگین به مشکل خورد، یه بار دیگه امتحان کنید.</p>

<h2 id="مرحله-دهم-import-کردن-harvester-به-rancher">مرحله دهم: Import کردن Harvester به Rancher</h2>

<p>بعد از نصب پلاگین، گزینه Import Harvester رو می‌زنید. Rancher یه فایل YAML برای شما generate می‌کنه. این فایل رو بردارید و به Harvester اضافه کنید:</p>

<p>از تنظیمات Harvester وارد <strong>Advanced → Settings</strong> بشید و مقدار <code class="language-bash highlighter-rouge">cluster-registration-url</code> رو به چیزی شبیه این تغییر بدید:</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="syntax"><code>https://192.168.1.112/v3/import/zslj74fbjrklhxqnr447frjsj5bxxxxxxxxxxxxx.yaml
</code></pre></div></div>

<p>چند دقیقه بعد کلاستر Harvester توی Rancher نشون داده میشه.</p>

<h2 id="مرحله-آخر-ساختن-کلاستر-kubernetes-با-harvester-در-rancher">مرحله آخر: ساختن کلاستر Kubernetes با Harvester در Rancher</h2>

<p>حالا به نقطه تلاقی Rancher و Harvester رسیدیم — جایی که کلاسترمون رو می‌سازیم و اپلیکیشن‌هامون رو اجرا می‌کنیم.</p>

<p>فرایند کلی اینه:</p>

<ol>
  <li><strong>ساختن کلاستر جدید</strong> از طریق Rancher UI با انتخاب Harvester به عنوان Infrastructure Provider</li>
  <li><strong>اضافه کردن Node Pool</strong> با تنظیماتی که بسته به محیط شما می‌تونه فرق داشته باشه</li>
</ol>

<p><img src="assets/article_images/harvester-homelab-setup/cluster-image-and-network.png" alt="" title="Rancher Harvester Downstream Cluster Network and Image" /></p>

<p><img src="assets/article_images/harvester-homelab-setup/cluster-user-network-cloudinit.png" alt="" title="Rancher Harvester Downstream Cluster Netowork and User Data Cloudinit" /></p>

<p>چون من یه کلاستر single-node Harvester دارم، باید این مقادیر رو به تنظیمات YAML کلاستر اضافه کنم تا توی مرحله bootstrap گیر نکنه:</p>

<div class="language-yaml highlighter-rouge"><div class="highlight"><pre class="syntax"><code><span class="na">global</span><span class="pi">:</span>
  <span class="na">cattle</span><span class="pi">:</span>
    <span class="na">clusterName</span><span class="pi">:</span> <span class="s">cool-cluster</span>
  <span class="na">tolerations</span><span class="pi">:</span>
    <span class="pi">-</span> <span class="na">effect</span><span class="pi">:</span> <span class="s">NoSchedule</span>
      <span class="na">key</span><span class="pi">:</span> <span class="s">node.cloudprovider.kubernetes.io/uninitialized</span>
      <span class="na">operator</span><span class="pi">:</span> <span class="s">Exists</span>
    <span class="pi">-</span> <span class="na">effect</span><span class="pi">:</span> <span class="s">NoSchedule</span>
      <span class="na">key</span><span class="pi">:</span> <span class="s">node-role.kubernetes.io/control-plane</span>
      <span class="na">operator</span><span class="pi">:</span> <span class="s">Exists</span>
    <span class="pi">-</span> <span class="na">effect</span><span class="pi">:</span> <span class="s">NoSchedule</span>
      <span class="na">key</span><span class="pi">:</span> <span class="s">node-role.kubernetes.io/master</span>
</code></pre></div></div>

<blockquote>
  <p><strong>توضیح:</strong> این toleration‌ها لازم هستن چون در یه محیط single-node، بعضی node‌ها ممکنه در ابتدا uninitialized باشن یا نقش control-plane داشته باشن. بدون این تنظیمات، workload‌های cloud provider نمی‌تونن روی اون نود schedule بشن و کلاستر توی مرحله bootstrap می‌مونه.</p>
</blockquote>

<h2 id="جمعبندی">جمع‌بندی</h2>

<p>تا اینجا یه زیرساخت کامل خونگی داریم:</p>

<ul>
  <li><strong>Harvester</strong> به عنوان لایه IaaS که مجازی‌سازی و storage رو با هم مدیریت می‌کنه</li>
  <li><strong>Rancher</strong> به عنوان کنترل پنل مرکزی</li>
  <li>یه <strong>کلاستر Kubernetes</strong> آماده برای deploy کردن اپلیکیشن</li>
</ul>

<p>قدم بعدی؟ نصب ابزارهایی مثل ArgoCD برای GitOps، یا راه‌اندازی Longhorn برای persistent storage — ولی این‌ها داستان پست‌های بعدیه.</p>]]></content><author><name>Behrouz Hasanbeygi</name></author><category term="development" /><summary type="html"><![CDATA[مقدمه: اکوسیستم Rancher]]></summary><media:thumbnail xmlns:media="http://search.yahoo.com/mrss/" url="https://behroozam.com/assets/article_images/harvester-homelab-setup/harvester-homelab-setup.png" /><media:content medium="image" url="https://behroozam.com/assets/article_images/harvester-homelab-setup/harvester-homelab-setup.png" xmlns:media="http://search.yahoo.com/mrss/" /></entry><entry><title type="html">نصب Proxmox با PXE Boot: وقتی فلش درایو از کار می‌افته!</title><link href="https://behroozam.com/proxmox-pxe-boot.html" rel="alternate" type="text/html" title="نصب Proxmox با PXE Boot: وقتی فلش درایو از کار می‌افته!" /><published>2026-04-26T00:00:00+00:00</published><updated>2026-04-26T00:00:00+00:00</updated><id>https://behroozam.com/proxmox-pxe-boot</id><content type="html" xml:base="https://behroozam.com/proxmox-pxe-boot.html"><![CDATA[<p>یه لپتاپ ThinkPad P14s Gen3 داشتم که بلااستفاده یه گوشه خونه افتاده بود. قبلاً سعی کرده بودم با <strong>Bazzite</strong> ازش یه کنسول خانگی بسازم، ولی از اونجایی که GPU داخلی این لپتاپ یعنی <strong>T550</strong> توانایی اجرای بازی‌های مدرن با کیفیت مناسب رو نداره و صرفاً به درد indie game می‌خوره، این کار برای سخت‌افزار قدرتمند لپتاپ به نظر هدر دادن منابع بود.</p>

<p>پس تصمیم گرفتم <strong>Proxmox</strong> رو روش نصب کنم تا در کنار کلاینت Dell OptiPlex 3060 Micro که تو خونه دارم، یه نود دیگه به کلاستر Proxmox من اضافه بشه. اما روش معمول نصب رو به کار نبردم…</p>

<h2 id="چرا-pxe-boot">چرا PXE Boot؟</h2>

<p>داستان از اینجا شروع شد که USB stick من از کار افتاد و دیگه روی سیستم mount نمی‌شد. به همین دلیل تصمیم گرفتم برم سراغ <strong>PXE Boot</strong>.</p>

<p>یه نکته مهم: برای PXE boot روی P14s Gen3، تنها راه موجود اینه که از <strong>کابل LAN</strong> برای اتصال کارت شبکه اترنت به سوییچ استفاده کنید. از طریق WLAN این کار رو نمیشه انجام داد، چون حداقل روی BIOS اکثر دستگاه‌های Lenovo، قابلیت PXE boot از طریق WiFi وجود نداره.</p>

<h2 id="راهاندازی-اولیه-با-serva-ویندوز">راه‌اندازی اولیه با Serva (ویندوز)</h2>

<p>برای PXE boot روی ویندوز رفتم سراغ یه ابزار freemium به اسم <strong><a href="https://www.vercot.com/~serva/">Serva</a></strong>. نسخه رایگان تا ۵۰ دقیقه بدون محدودیت کار می‌کنه که برای نصب Proxmox روی یه کلاینت کافیه.</p>

<p>تنظیمات اولیه Serva ساده بود:</p>
<ul>
  <li><strong>TFTP Server</strong> برای لود کردن <code class="language-bash highlighter-rouge">initramfs</code> و <code class="language-bash highlighter-rouge">vmlinuz</code></li>
  <li><strong>DHCP Proxy</strong> برای لود کردن ISO مربوط به Proxmox و شروع فرایند نصب</li>
</ul>

<p>فایل ISO رو مستقیم داخل دایرکتوری <code class="language-bash highlighter-rouge">Serva_Root<span class="se">\N</span>WA_PXE</code> از حالت فشرده خارج کردم.</p>

<blockquote>
  <p>⚠️ <strong>توجه:</strong> WinRAR اسامی فایل‌ها رو تغییر می‌ده. بهتره ISO رو اول به صورت یه disk مجازی mount کنید و بعد با <code class="language-bash highlighter-rouge">xcopy</code> محتواش رو انتقال بدید.</p>
</blockquote>

<h2 id="مشکل-اول-پارامترهای-kernel-کار-نمیکردن">مشکل اول: پارامترهای kernel کار نمی‌کردن</h2>

<p>اولین مشکل این بود که پارامترهایی که به kernel پاس داده بودم کار نمی‌کردن. مثلاً می‌خواستم به صورت خودکار از DHCP server روتر IP بگیرم، ولی این اتفاق نمی‌افتاد.</p>

<p>برای عیب‌یابی رفتم سراغ <code class="language-bash highlighter-rouge">dmesg</code>، ولی مشکلی پیدا نشد و همه درایورها سالم لود شده بودن. در مرحله بعد با دستور <code class="language-bash highlighter-rouge">lspci <span class="nt">-nn</span></code> بررسی کردم چه سخت‌افزارهایی شناسایی شدن و متوجه شدم <strong>درایور کارت شبکه <code class="language-bash highlighter-rouge">e1000e</code> لود نشده</strong>. به همین دلیل هم <code class="language-bash highlighter-rouge">ip <span class="nb">link </span>show</code> جز <code class="language-bash highlighter-rouge">lo</code> هیچ اینترفیس دیگه‌ای نشون نمی‌داد.</p>

<h2 id="راهحل-افزودن-درایور-شبکه-به-initramfs">راه‌حل: افزودن درایور شبکه به initramfs</h2>

<p>تصمیم گرفتم درایور شبکه رو مستقیم داخل <code class="language-bash highlighter-rouge">initramfs</code> قرار بدم تا موقع بوت، IP بتونه گرفته بشه. برای این کار به فایل <code class="language-bash highlighter-rouge">proxmox-kernel-6.17.2-1-pve-signed_6.17.2-1_amd64.deb</code> نیاز داشتم.</p>

<p><strong>مرحله ۱ - دانلود پکیج kernel:</strong></p>
<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="syntax"><code>wget http://download.proxmox.com/debian/pve/dists/trixie/pve-no-subscription/binary-amd64/proxmox-kernel-6.17.2-1-pve-signed_6.17.2-1_amd64.deb
</code></pre></div></div>

<p><strong>مرحله ۲ - استخراج محتوا:</strong></p>
<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="syntax"><code>ar x proxmox-kernel-6.17.2-1-pve-signed_6.17.2-1_amd64.deb
<span class="nb">tar</span> <span class="nt">-xvf</span> data.tar.xz
</code></pre></div></div>

<p>درایور مورد نظر در مسیر زیر قرار داره:</p>
<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="syntax"><code>/lib/modules/6.17.2-1-pve/kernel/drivers/net/ethernet/intel/e1000e/e1000e.ko
</code></pre></div></div>

<p><strong>مرحله ۳ - استخراج initramfs:</strong></p>
<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="syntax"><code><span class="nb">mkdir </span>initramfs_build
<span class="nb">cp </span>initrd.img initramfs_build/
<span class="nb">cd </span>initramfs_build
zstd <span class="nt">-dc</span> initrd.img | cpio <span class="nt">-idmv</span>
</code></pre></div></div>

<p><strong>مرحله ۴ - افزودن درایور و repack کردن:</strong></p>
<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="syntax"><code><span class="nb">mkdir</span> <span class="nt">-p</span> lib/modules/6.17.2-1-pve/kernel/drivers/net/ethernet/intel/e1000e/
<span class="nb">cp</span> ../driver/lib/modules/6.17.2-1-pve/kernel/drivers/net/ethernet/intel/e1000e/e1000e.ko <span class="se">\</span>
   lib/modules/6.17.2-1-pve/kernel/drivers/net/ethernet/intel/e1000e/

find <span class="nb">.</span> | cpio <span class="nt">-o</span> <span class="nt">-H</span> newc | zstd <span class="nt">-19</span> <span class="nt">-T0</span> <span class="o">&gt;</span> ../initrd.img

</code></pre></div></div>

<h2 id="مشکل-دوم-dhcp-هنوز-کار-نمیکنه">مشکل دوم: DHCP هنوز کار نمی‌کنه</h2>

<p>بعد از reboot، اینترفیس <code class="language-bash highlighter-rouge">eth0</code> به خوبی لود شد، ولی مشکل DHCP کماکان ادامه داشت. با بررسی اسکریپت <code class="language-bash highlighter-rouge">init</code> متوجه شدم فرایند لود کردن ISO <strong>مستقل از شبکه</strong> هست و کاملاً مبتنی بر cdrom.</p>

<p>دو راه جلوم بود:</p>

<table>
  <thead>
    <tr>
      <th style="text-align: right">مشکل</th>
      <th style="text-align: right">توضیح</th>
      <th style="text-align: right">راه</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: right">TFTP خیلی کنده برای این حجم</td>
      <td style="text-align: right">قرار دادن proxmox.iso (~2GB) کنار initramfs</td>
      <td style="text-align: right">ادغام ISO با initramfs</td>
    </tr>
    <tr>
      <td style="text-align: right">نیاز به تغییر اسکریپت init</td>
      <td style="text-align: right">لود initramfs با TFTP، سپس دانلود ISO با <code class="language-bash highlighter-rouge">wget</code></td>
      <td style="text-align: right">دانلود ISO بعد از بوت</td>
    </tr>
  </tbody>
</table>

<h2 id="راهحل-نهایی-دانلود-iso-از-طریق-http">راه‌حل نهایی: دانلود ISO از طریق HTTP</h2>

<p>چون TFTP برای انتقال فایل‌های بزرگ مناسب نیست، به سراغ <strong>HTTP</strong> رفتم. HTTP server خود Serva ارور می‌داد، پس از وب‌سرور <strong><a href="https://github.com/jpillora/serve">serve</a></strong> که binary ویندوز هم داشت استفاده کردم؛ اما بعد از دانلود فایل حجیم <code class="language-bash highlighter-rouge">initrd.img</code> crash می‌کرد.</p>

<p>پس رفتم سراغ <strong>راه دوم</strong>: لود اولیه <code class="language-bash highlighter-rouge">initramfs</code> با TFTP و بعد دانلود ISO با <code class="language-bash highlighter-rouge">wget</code>. این تغییرات رو به اسکریپت <code class="language-bash highlighter-rouge">init</code> اضافه کردم:</p>

<div class="language-sh highlighter-rouge"><div class="highlight"><pre class="syntax"><code><span class="c"># --- Network Injection Start ---</span>
<span class="nb">echo</span> <span class="s2">"Initializing Network..."</span>
/sbin/ip <span class="nb">link set </span>eth0 up
<span class="nb">sleep </span>2
ip addr add 192.168.1.155/24 dev eth0
ip route add default via 192.168.1.1

<span class="nb">echo</span> <span class="s2">"Downloading ISO via HTTP..."</span>
/bin/mkdir <span class="nt">-p</span> /mnt/netboot

wget http://192.168.1.102:3000/proxmox-ve_9.1-1.iso <span class="nt">-O</span> /tmp/proxmox.iso

<span class="k">if</span> <span class="o">[</span> <span class="nt">-f</span> /tmp/proxmox.iso <span class="o">]</span><span class="p">;</span> <span class="k">then
    </span><span class="nb">echo</span> <span class="s2">"ISO Download Successful. Loop-mounting..."</span>
    /bin/mount <span class="nt">-o</span> loop,ro /tmp/proxmox.iso /mnt
<span class="k">else
    </span><span class="nb">echo</span> <span class="s2">"HTTP Download Failed."</span>
<span class="k">fi</span>
<span class="c"># --- Network Injection End ---</span>
</code></pre></div></div>

<p>و خط <code class="language-bash highlighter-rouge"><span class="nv">cdrom</span><span class="o">=</span><span class="s2">""</span></code> رو به این تغییر دادم:</p>
<div class="language-sh highlighter-rouge"><div class="highlight"><pre class="syntax"><code><span class="nv">cdrom</span><span class="o">=</span><span class="s2">"/tmp/proxmox.iso"</span>
</code></pre></div></div>

<p>و بعد دوباره initramfs رو ساختم</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="syntax"><code>find <span class="nb">.</span> | cpio <span class="nt">-o</span> <span class="nt">-H</span> newc | zstd <span class="nt">-19</span> <span class="nt">-T0</span> <span class="o">&gt;</span> ../initrd.img
</code></pre></div></div>

<p>اینطوری تونستم وارد بخش نصب Proxmox بشم! ✅</p>

<p>البته این ساده‌ترین راه نبود. اگه تعداد زیادی دستگاه با سخت‌افزارهای مختلف داشته باشیم، این روش بهترین گزینه نیست؛ هرچند چیزهای زیادی درباره نحوه بوت شدن لینوکس ازش یاد گرفتم.</p>

<h2 id="راهحل-بهتر-netbootxyz--dnsmasq">راه‌حل بهتر: netboot.xyz + dnsmasq</h2>

<p>برای روش اول (قرار دادن ISO کنار initramfs) به این نتیجه رسیدم که <strong>Serva ابزار مناسبی نیست</strong>، چون:</p>
<ul>
  <li>بعد از دانلود <code class="language-bash highlighter-rouge">initramfs</code> حجیم crash می‌کنه</li>
  <li>ابزار مورد علاقه‌ام برای DHCP یعنی <strong>dnsmasq</strong> رو پشتیبانی نمی‌کنه</li>
</ul>

<p>پس بیخیال ویندوز شدم و رفتم سراغ <strong><a href="https://netboot.xyz">netboot.xyz</a></strong>:</p>

<ol>
  <li>با <strong>proxyDHCP</strong> پارامترهای boot رو به PXE client ارسال می‌کنم</li>
  <li>فایل‌های <code class="language-bash highlighter-rouge">initramfs</code> (initrd) و <code class="language-bash highlighter-rouge">vmlinuz</code> (linux26) رو از طریق netboot تحویل PXE client می‌دم</li>
</ol>

<p>برای ترکیب <code class="language-bash highlighter-rouge">dnsmasq</code> و <code class="language-bash highlighter-rouge">netboot.xyz</code> این <a href="https://github.com/behroozam/netboot-proxmox">repo</a> رو آماده کردم. کافیه روی یه هاست <strong>لینوکسی</strong> اجراش کنید.</p>

<blockquote>
  <p>⚠️ <strong>نکته:</strong> هاست ویندوز مناسب نیست، چون container روی یه VM اجرا می‌شه و درخواست DHCP Discovery به دست dnsmasq نمی‌رسه.</p>
</blockquote>

<p>در آخر کافیه یه دایرکتوری بسازید و فایل‌های <code class="language-bash highlighter-rouge">initrd.img</code> و <code class="language-bash highlighter-rouge">linux26</code> رو که با ISO pack شدن، اونجا قرار بدید:</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="syntax"><code>
<span class="nb">cd </span>boot
<span class="nb">cd </span>initramfs_build
<span class="nb">mv</span> ../proxmox-ve_9.1-1.iso proxmox.iso
find <span class="nb">.</span> | cpio <span class="nt">-o</span> <span class="nt">-H</span> newc | zstd <span class="nt">-19</span> <span class="nt">-T0</span> <span class="o">&gt;</span> ../initrd.img
<span class="nb">cd</span> ..
git clone https://github.com/behroozam/netboot-proxmox.git
<span class="nb">cd </span>netboot-proxmox
<span class="nb">mkdir </span>assets/proxmox/9.1-1/
<span class="c"># initrd.img و linux26 رو اینجا کپی کنید</span>
<span class="nb">cp</span> ../<span class="o">{</span>initrd.img,linux26<span class="o">}</span> assets/proxmox/9.1-1/

docker-compose up <span class="nt">-d</span>
</code></pre></div></div>

<p>اگه همه چیز درست پیش بره، صفحه نصب زیبای Proxmox رو خواهید دید. 🎉</p>]]></content><author><name>Behrouz Hasanbeygi</name></author><category term="development" /><summary type="html"><![CDATA[یه لپتاپ ThinkPad P14s Gen3 داشتم که بلااستفاده یه گوشه خونه افتاده بود. قبلاً سعی کرده بودم با Bazzite ازش یه کنسول خانگی بسازم، ولی از اونجایی که GPU داخلی این لپتاپ یعنی T550 توانایی اجرای بازی‌های مدرن با کیفیت مناسب رو نداره و صرفاً به درد indie game می‌خوره، این کار برای سخت‌افزار قدرتمند لپتاپ به نظر هدر دادن منابع بود.]]></summary><media:thumbnail xmlns:media="http://search.yahoo.com/mrss/" url="https://behroozam.com/assets/article_images/proxmox-pxe-boot/proxmox-pxe-boot.png" /><media:content medium="image" url="https://behroozam.com/assets/article_images/proxmox-pxe-boot/proxmox-pxe-boot.png" xmlns:media="http://search.yahoo.com/mrss/" /></entry><entry><title type="html">اجرا کردن فیدیبو به وسیله Waydroid روی گنو/لینوکس</title><link href="https://behroozam.com/fidibo-waydroid.html" rel="alternate" type="text/html" title="اجرا کردن فیدیبو به وسیله Waydroid روی گنو/لینوکس" /><published>2024-05-15T00:00:00+00:00</published><updated>2024-05-15T00:00:00+00:00</updated><id>https://behroozam.com/fidibo-waydroid</id><content type="html" xml:base="https://behroozam.com/fidibo-waydroid.html"><![CDATA[<p>تازگی ها برای تفنن از Arch Linux روی لپتاپ جدیدم استفاده میکنم</p>

<ol>
  <li>یه مقداریش برمیگرده به اینکه دوست داشتم تنوع بدم و دیگه از Ubuntu استفاده نکنم چون روی سرور و WSL از ابونتو استفاده میکنم.</li>
  <li>دلیل دیگه اش هم برمیگشت به تجربه نه چندان دوست داشتنی که با <a href="https://nixos.org">NixOS</a> داشتم.</li>
  <li>اگه ارچ وجود نداشت احتمالا انتخابم <a href="https://www.gentoo.org/">Gentoo</a> میبود.</li>
  <li>خارج شدن از کنج عافیت<sup id="fnref:1"><a href="#fn:1" class="footnote" rel="footnote" role="doc-noteref">1</a></sup></li>
</ol>

<p>به نظرم Arch اون تعادلی که بین خیلی ساختار یافته بودن سیستم عامل و سهل گیری رو داره و استفاده از اون برای من دوست داشتنیه.</p>

<p>اما برگردیم به ماجرای اجرا کردن فیدیبو روی لینوکس.
چهار سال قبل درمورد این <a href="/fidibo-anbox">نوشتم</a> که چطور فیدیبو رو به وسیله anbox روی گنو/لینوکس اجرا کنیم اما دیروز که داشتم نگاه میکردم متوجه شدم که anbox دیگه توسعه داده نمیشه ولی یه پروژه مشابه شده وجود داره که همون مسیر اجرا کردن اندروید به عنوان کانتینر روی لینوکسه.</p>

<h3 id="چرا-waydroid-">چرا Waydroid ؟</h3>

<p>برای اجرا کردن اپلیکیشن های اندروید روی کرنل لینوکس ما دوتا راه بیشتر نداریم یا اینکه از مجازی‌ساز<sup id="fnref:2"><a href="#fn:2" class="footnote" rel="footnote" role="doc-noteref">2</a></sup> استفاده کنیم یا اینکه پروسه رو به وسیله کانتیتر<sup id="fnref:3"><a href="#fn:3" class="footnote" rel="footnote" role="doc-noteref">3</a></sup> اجرا کنیم.</p>

<p>مسیر اول که استفاده از مجازی‌ساز باشه رو تو <a href="/fidibo-anbox">مقاله</a> قبلی بهش اشاره کردم مناسب سیستم های ضعیف نیست.</p>

<p>فعلا جایگزینی برای Waydroid وجود نداره که ساده تر باشه.</p>

<h3 id="نصب-و-اجرای-waydroid-روی-arch">نصب و اجرای Waydroid روی Arch</h3>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="syntax"><code><span class="c"># installing yay aur package manager</span>
pacman <span class="nt">-Sy</span> <span class="nt">--needed</span> git base-devel
git clone https://aur.archlinux.org/yay.git
<span class="nb">cd </span>yay
makepkg <span class="nt">-si</span>

<span class="c">#Change the Arch kernel to zen kernel</span>

<span class="nb">sudo </span>pacman <span class="nt">-S</span> linux-zen linux-zen-headers

reboot

<span class="c">#install Waydroid</span>
yay <span class="nt">-S</span> waydroid

<span class="c">#running Waydroid serivce</span>
<span class="nb">sudo </span>systemctl start waydroid-container.service

<span class="c">#enable the waydroid service(optional)</span>
<span class="nb">sudo </span>systemctl <span class="nb">enable </span>waydroid-container.service

<span class="c">#init and usage of waydroid</span>

<span class="nb">sudo </span>waydroid init

waydroid show-full-ui

waydroid app <span class="nb">install </span>fidibo.apk

</code></pre></div></div>

<p>اگه همه چیز به خوبی و خوشی پیش رفته باشه حالا میتونید کتاب مورد علاقه خودتون رو بخونید</p>

<p><img src="assets/article_images/waydroid/the-way-of-kings-persian.png" alt="کتاب طریق شاهان" /></p>

<div class="footnotes" role="doc-endnotes">
  <ol>
    <li id="fn:1">
      <p>Comfort Zone <a href="#fnref:1" class="reversefootnote" role="doc-backlink">&#8617;</a></p>
    </li>
    <li id="fn:2">
      <p>Virtualization <a href="#fnref:2" class="reversefootnote" role="doc-backlink">&#8617;</a></p>
    </li>
    <li id="fn:3">
      <p>Container <a href="#fnref:3" class="reversefootnote" role="doc-backlink">&#8617;</a></p>
    </li>
  </ol>
</div>]]></content><author><name>Behrouz Hasanbeygi</name></author><category term="development" /><summary type="html"><![CDATA[تازگی ها برای تفنن از Arch Linux روی لپتاپ جدیدم استفاده میکنم]]></summary><media:thumbnail xmlns:media="http://search.yahoo.com/mrss/" url="https://behroozam.com/assets/article_images/waydroid/waydroid.png" /><media:content medium="image" url="https://behroozam.com/assets/article_images/waydroid/waydroid.png" xmlns:media="http://search.yahoo.com/mrss/" /></entry><entry><title type="html">چرا IPAM مهمه و چجوری از اون تو زیرساخت خودمون استفاده کنیم؟</title><link href="https://behroozam.com/ipam.html" rel="alternate" type="text/html" title="چرا IPAM مهمه و چجوری از اون تو زیرساخت خودمون استفاده کنیم؟" /><published>2024-05-06T00:00:00+00:00</published><updated>2024-05-06T00:00:00+00:00</updated><id>https://behroozam.com/ipam</id><content type="html" xml:base="https://behroozam.com/ipam.html"><![CDATA[<p>تو مقاله <a href="/web-application-system-design.html">مسیری که طی میشود تا به یک وبسایت برسیم</a> به صورت مفصل از اهمیتی که دانش شبکه برای یه مهندس دواپس داره صحبت کردم یعنی دانشی که کمک میکنه متوجه بشه چه خطایی ممکنه تو سیستم اتفاق افتاده باشه.</p>

<p>اما دانش خطایابی تنها یکی از اون چیزاییه که یه مهندس دواپس خوب رو میسازه و معماری صحیح سیستم یکی دیگه از اون مهارت هایی که کمک میکنه مهندس های بهتری باشیم.</p>

<p>برای معماری درست زیرساخت ما ابتدا باید شاکله اصلی یعنی تخصیص درست منابع رو بلد باشیم و همون طور که میدونید تعداد IP ها و range های اون ها هم بی انتها نیست و اکثر مواقع برای اینکه بین range های ما همپوشانی وجود نداشته باشه باید دست به دامن ابزارهای مستندسازی بشیم.</p>

<blockquote>
  <p>⚠️ توجه: داشتن دانش حداقلی از IP برای فهم مطالب زیر الزامیه.
توصیه میکنم اگه نیاز به آموزش دارین دوره رایگان network+ اردشیر کاویانی رو روی <a href="https://www.youtube.com/watch?v=9t1RXmoaRpM&amp;list=PL1OoRITklYLjTid8GeMffc-RlsWKYosFq&amp;ab_channel=4rahecomputer">یوتوب</a> ببینید.</p>
</blockquote>

<h3 id="چه-روش-هایی-برای-subnetting-وجود-داره">چه روش هایی برای subnetting وجود داره؟</h3>

<p>ساده ترین راه اینه که از یه وبسایت مثل <a href="https://www.davidc.net/sites/default/subnets/subnets.html">این</a> استفاده کنیم و subnet های خودمون رو بر اساس bitmask که میخوایم بسازیم برای مثال اگه از بازه <code class="language-bash highlighter-rouge">192.168.0.0/16</code> استفاده کنیم میتونیم این رو به دو یا چند subnet دیگه بشکونیم به این صورت تصویری که میبینید</p>

<p><img src="assets/article_images/ipam/subnetting.png" alt="" title="subnetting" /></p>

<p>این روش با اینکه ساده است اما معایبی هم داره مثل:</p>

<ol>
  <li>بعد از تقسیم بازه به subnet های کوچکتر باید مستندسازی رو جای دیگری انجام داد مثلا تو یک فایل متنی ذخیره کرد.</li>
  <li>باید هربار داده های قبلی رو اضافه کرد و سیستم کمکی به ما جهت تخصیص منابع نمیکنه مثلا اگه از قبل یه بازه استفاده شده باشه هشدار نمیده.</li>
</ol>

<p>اما راه ساده تر و بهتری هم برای مستندسازی و ایجاد IP و Prefix وجود داره و اونم استفاده از ابزارهای IPAM هستش
ابزارهایی مثل</p>

<ol>
  <li><a href="https://docs.netbox.dev/en/stable/">netbox</a></li>
  <li><a href="https://phpipam.net/">phpipam</a></li>
</ol>

<p>کاری که این ابزارها انجام میدن فراهم کردن یه رابط کاربری/API برای ایجاد و مدیریت و نگهداری دیتایی که درمورد IP تو سیستم ما وجود داره حالا این IP میتونه یه range/prefix باشه میتونه firewall باشه میتونه virtual machine باشه ولی اصل ماجرا اینه که یه source of truth وجود داره که میتونیم بهش اطمینان کنیم که IP رو به درستی تخصیص دادیم.
در ادامه چند مثال رو به وسیله <a href="https://registry.terraform.io/providers/e-breuninger/netbox/latest/docs">netbox terraform provider</a> میزنم تا موضوع بیشتر جا بیفته.</p>

<h3 id="چطور-میتونیم-از-netbox-برای-ایجاد-subnet-استفاده-کنیم">چطور میتونیم از netbox برای ایجاد subnet استفاده کنیم؟</h3>

<p>مرحله اول نصب netbox هستش که از حوصله این مقاله خارجه ولی میتونید از این <a href="https://github.com/netbox-community/netbox-chart">helm chart</a> برای نصب netbox آستفاده کنیم.</p>

<p>مرحله بعدی استفاده از api_token است که میتونه متعلق به admin باشه که به صورت پیشفرض مقدارش <code class="language-bash highlighter-rouge">0123456789abcdef0123456789abcdef01234567</code> است.</p>

<h4 id="استفاده-از-netbox-terraform-provider">استفاده از netbox terraform provider</h4>

<p>ساختار پروژه تستی ما به این صورت است</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="syntax"><code>+-- main.tf
<span class="se">\-</span>- providers.tf
</code></pre></div></div>

<p>محتوای providers.tf</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="syntax"><code>terraform <span class="o">{</span>
  required_providers <span class="o">{</span>
    netbox <span class="o">=</span> <span class="o">{</span>
      <span class="nb">source</span>  <span class="o">=</span> <span class="s2">"e-breuninger/netbox"</span>
      version <span class="o">=</span> <span class="s2">"3.8.5"</span>
    <span class="o">}</span>
  <span class="o">}</span>
<span class="o">}</span>

provider <span class="s2">"netbox"</span> <span class="o">{</span>
  server_url <span class="o">=</span> <span class="s2">"https://yournetbox.com"</span>
  api_token  <span class="o">=</span> <span class="s2">"0123456789abcdef0123456789abcdef01234567"</span>
<span class="o">}</span>

</code></pre></div></div>

<p>محتوای main.tf</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="syntax"><code>
resource <span class="s2">"netbox_prefix"</span> <span class="s2">"test"</span> <span class="o">{</span>
  prefix <span class="o">=</span> <span class="s2">"192.168.0.0/16"</span>
  status <span class="o">=</span> <span class="s2">"active"</span>
<span class="o">}</span>

resource <span class="s2">"netbox_available_prefix"</span> <span class="s2">"test"</span> <span class="o">{</span>
  parent_prefix_id <span class="o">=</span> netbox_prefix.test.id
  description      <span class="o">=</span> <span class="s2">"Test"</span>
  prefix_length    <span class="o">=</span> 25
  status           <span class="o">=</span> <span class="s2">"active"</span>
<span class="o">}</span>

output <span class="s2">"test"</span> <span class="o">{</span>
  value <span class="o">=</span> netbox_available_prefix.test
<span class="o">}</span>

</code></pre></div></div>

<p>خروجی terraform plan</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="syntax"><code>➜  netbox tf plan

Terraform used the selected providers to generate the following execution plan. Resource actions are indicated with the following symbols:
  + create

Terraform will perform the following actions:

  <span class="c"># netbox_available_prefix.test will be created</span>
  + resource <span class="s2">"netbox_available_prefix"</span> <span class="s2">"test"</span> <span class="o">{</span>
      + description      <span class="o">=</span> <span class="s2">"Test"</span>
      + <span class="nb">id</span>               <span class="o">=</span> <span class="o">(</span>known after apply<span class="o">)</span>
      + parent_prefix_id <span class="o">=</span> <span class="o">(</span>known after apply<span class="o">)</span>
      + prefix           <span class="o">=</span> <span class="o">(</span>known after apply<span class="o">)</span>
      + prefix_length    <span class="o">=</span> 25
      + status           <span class="o">=</span> <span class="s2">"active"</span>
    <span class="o">}</span>

  <span class="c"># netbox_prefix.test will be created</span>
  + resource <span class="s2">"netbox_prefix"</span> <span class="s2">"test"</span> <span class="o">{</span>
      + <span class="nb">id</span>     <span class="o">=</span> <span class="o">(</span>known after apply<span class="o">)</span>
      + prefix <span class="o">=</span> <span class="s2">"192.168.0.0/16"</span>
      + status <span class="o">=</span> <span class="s2">"active"</span>
    <span class="o">}</span>

Plan: 2 to add, 0 to change, 0 to destroy.

Changes to Outputs:
  + <span class="nb">test</span> <span class="o">=</span> <span class="o">{</span>
      + description      <span class="o">=</span> <span class="s2">"Test"</span>
      + <span class="nb">id</span>               <span class="o">=</span> <span class="o">(</span>known after apply<span class="o">)</span>
      + is_pool          <span class="o">=</span> null
      + mark_utilized    <span class="o">=</span> null
      + parent_prefix_id <span class="o">=</span> <span class="o">(</span>known after apply<span class="o">)</span>
      + prefix           <span class="o">=</span> <span class="o">(</span>known after apply<span class="o">)</span>
      + prefix_length    <span class="o">=</span> 25
      + role_id          <span class="o">=</span> null
      + site_id          <span class="o">=</span> null
      + status           <span class="o">=</span> <span class="s2">"active"</span>
      + tags             <span class="o">=</span> null
      + tenant_id        <span class="o">=</span> null
      + vlan_id          <span class="o">=</span> null
      + vrf_id           <span class="o">=</span> null
    <span class="o">}</span>

</code></pre></div></div>

<p>اگه همه چی به خوبی پیش رفته باشه با اجرای <code class="language-bash highlighter-rouge">terraform apply</code> باید <code class="language-bash highlighter-rouge">192.168.0.0/16</code> به عنوان parent و یه اولین رنج خالی به عنوان subnet ساخته شده باشه.</p>

<h3 id="کاربرد-واقعی-استفاده-از-netbox-terraform-provider-کجاست">کاربرد واقعی استفاده از netbox terraform provider کجاست؟</h3>

<p>مثال بالا سناریو ساده ساختن یه نتورک و ایجاد یه سابنت بود ولی تو دنیای واقعی زیرساخت بسیار بزرگ تر و پیچیده تر از اونه که بتونیم همه prefix ها و IP ها رو به خاطر بسپاریم علاوه بر این تخصیص دستی manual و هربار داکیومنت کردنش وقتگیر و غیر ضروریه اینجاست که netbox به کمک ما میاد تا این پیچیدگی ها رو ساده کنه.</p>

<p>از اونجایی که terraform به صورت defacto زبان کلاود تبدیل شده این یکپارچگی با netbox کمک میکنه زیرساخت قابل فهم تری داشته باشیم که تو مقیاس بزرگتر دید بهتری رو به معمار و تیم توسعه و نگهداری میده.</p>]]></content><author><name>Behrouz Hasanbeygi</name></author><category term="development" /><summary type="html"><![CDATA[تو مقاله مسیری که طی میشود تا به یک وبسایت برسیم به صورت مفصل از اهمیتی که دانش شبکه برای یه مهندس دواپس داره صحبت کردم یعنی دانشی که کمک میکنه متوجه بشه چه خطایی ممکنه تو سیستم اتفاق افتاده باشه.]]></summary><media:thumbnail xmlns:media="http://search.yahoo.com/mrss/" url="https://behroozam.com/assets/article_images/ipam/Netbox_logo.png" /><media:content medium="image" url="https://behroozam.com/assets/article_images/ipam/Netbox_logo.png" xmlns:media="http://search.yahoo.com/mrss/" /></entry><entry><title type="html">چک کردن revoke گواهینامه SSL به وسیله پایتون</title><link href="https://behroozam.com/cehck-certificate-revoke-status-python.html" rel="alternate" type="text/html" title="چک کردن revoke گواهینامه SSL به وسیله پایتون" /><published>2023-10-16T00:00:00+00:00</published><updated>2023-10-16T00:00:00+00:00</updated><id>https://behroozam.com/cehck-certificate-revoke-status-python</id><content type="html" xml:base="https://behroozam.com/cehck-certificate-revoke-status-python.html"><![CDATA[<p>گاهی وقت ها لازم میشه که قبل از اینکه یه گواهی نامه SSL به پایان برسه ما اون رو revoke کنیم</p>

<h4 id="اما-پروسه-revoke-کردن-تو-گواهینامه-ssl-چیه">اما پروسه revoke کردن تو گواهینامه SSL چیه؟</h4>

<p><img src="assets/article_images/certificate-revoke/pubkey.png" alt="" title="Public key certificate" /></p>

<p>گواهی نامه SSL درواقع یه public key که توسط CA امضا شده روشی که برای امضا کردن این Public key استفاده میشه اینه که ما یه درخواست امضا کلید عمومی که شامل اطلاعاتی مثل کمپانی و منطقه زمانی و اطلاعاتی میشه که برای گواهی لازمه رو به یه CA بدیم تا اون رو برای ما امضا کنه و درنهایت یه کلید عمومی امضا شده به ما تحویل بده. <a href="https://www.digicert.com/easy-csr/openssl.htm">اینجا</a> برای مثال میتونید به راحتی یه درخواست CSR رو برای openssl بسازید و کپی کنید و تو خط فرمان خودتون اجرا کنید.</p>

<p>حالا گاهی وقتا پیش میاد که مثلا کلید خصوصی که باهاش درخواست CSR رو دادیم افشا میشه یا اینکه دیگه تمایلی نداریم که از گواهی فعلی استفاده کنیم و میخوایم که این گواهینامه رو به ملکوت اعلی بفرستیم.</p>

<p>دوتا روش برای اینکار وجود داره که ارائه دهنده های گواهینامه یا CA انجام میدن:</p>

<ul>
  <li>CRL یا Certificate revocation list</li>
  <li>OCSP یا Online Certificate Status Protocol</li>
</ul>

<p>این دو روش افزونه یا extention برای گواهینامه های استاندارد x509 هستند</p>

<h4 id="روش-crl">روش CRL</h4>

<p><img src="assets/article_images/certificate-revoke/CRL.png" alt="" title="CRL" /></p>

<p>تو روش CRL ارائه دهنده گواهینامه یه لیست از گواهی هایی که به پایان رسیده یا revoke شدن رو برای مرورگر یا سیستم ما ارسال میکنه و اینشکلی باعث میشه که سیستم ما متوجه بشه که اعتبار گواهینامه به پایان رسیده که تو تصویر بالا میتونید فرایندش رو ببینید</p>

<h4 id="روش-ocsp">روش OCSP</h4>

<p><img src="assets/article_images/certificate-revoke/OCSP-1.png" alt="" title="OCSP" /></p>

<p>روش OCSP روش مدرن تریه که کلاینت درخواست اعتبارسنجی رو مستقیما برای CA میفرسته تا تایید کنه</p>

<p>روش OCSP به دو حالت انجام میشه یا خود کلاینت درخواست رو به CA ارسال میکنه یا webserver از قبل درخواست رو ارسال میکنه و همراه با گواهی SSL تحویل کلاینت میده
روش دوم به خاطر اینکه بار رو از روی کلاینت برمیداره روش بهتری برای سخت افزارهایی هستش که توان پردازشی پایین تری رو دارند
مثلا توی nignx <a href="https://support.globalsign.com/ssl/ssl-certificates-installation/nginx-enable-ocsp-stapling">به این صورت</a> میشه این قابلیت رو فعال کرد.</p>

<p><img src="assets/article_images/certificate-revoke/OCSP-Stapling-1.png" alt="" title="OCSP-Stapling" /></p>

<h4 id="چطوری-به-وسیله-python-اعتبار-گواهی-نامه-ssl-رو-تایید-کنیم">چطوری به وسیله python اعتبار گواهی نامه SSL رو تایید کنیم</h4>

<p>برای این کار دوتا wrapper نوشته شده که میتونید از اونا برای validate کردن certificate استفاده کنید</p>

<ul>
  <li><a href="https://pypi.org/project/crl-checker/">crl-checker</a> برای CRL</li>
  <li><a href="https://pypi.org/project/ocsp-checker/">OCSP-Checker</a> برای OCSP</li>
</ul>

<p>من برای راحتی کار یه اسکریپت ساده نوشتم که هردوتا رو استفاده میکنه به این صورت که اول پیش نیاز ها رو نصب میکنیم</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="syntax"><code>pip <span class="nb">install </span>ocsp-checker crl-checker
</code></pre></div></div>

<p>و بعدش این اسکریپت رو تو یه فایل مثلا <code class="language-bash highlighter-rouge">main.py</code> ذخیره میکنیم</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="syntax"><code>import ssl
import argparse
from crl_checker import check_revoked, Revoked, Error
from ocspchecker import ocspchecker

parser <span class="o">=</span> argparse.ArgumentParser<span class="o">()</span>
parser.add_argument<span class="o">(</span><span class="s2">"hostname"</span><span class="o">)</span>
parser.add_argument<span class="o">(</span><span class="s2">"port"</span><span class="o">)</span>

args <span class="o">=</span> parser.parse_args<span class="o">()</span>


def get_server_certificate<span class="o">(</span><span class="nb">hostname</span>, port<span class="o">)</span>:
    cert <span class="o">=</span> ssl.get_server_certificate<span class="o">((</span><span class="nb">hostname</span>, port<span class="o">))</span>
    <span class="k">return </span>cert


def check_server_pem_revoked<span class="o">()</span>:
    cert_pem <span class="o">=</span> get_server_certificate<span class="o">(</span><span class="nb">hostname</span><span class="o">=</span>args.hostname, <span class="nv">port</span><span class="o">=</span>args.port<span class="o">)</span>
    try:
        check_revoked<span class="o">(</span>cert_pem<span class="o">)</span>
    except Revoked as e:
        print<span class="o">(</span>f<span class="s2">"Certificate revoked: {e}"</span><span class="o">)</span>
    except Error as e:
        print<span class="o">(</span>f<span class="s2">"Revocation check failed. Error: {e}"</span><span class="o">)</span>
        raise


def OCSP_revoked<span class="o">(</span><span class="nb">hostname</span>, port<span class="o">)</span>:
    ocsp_request <span class="o">=</span> ocspchecker.get_ocsp_status<span class="o">(</span><span class="nv">host</span><span class="o">=</span><span class="nb">hostname</span>, <span class="nv">port</span><span class="o">=</span>port<span class="o">)</span>
    <span class="k">return </span>ocsp_request


check_server_pem_revoked<span class="o">()</span>

OCSP_revoked<span class="o">(</span><span class="nb">hostname</span><span class="o">=</span>args.hostname, <span class="nv">port</span><span class="o">=</span>args.port<span class="o">)</span>


</code></pre></div></div>

<p>و حالا کافیه که ارگیومنت های خودمون رو به اسکریپت تو کامند لاین بدیم به این صورت
برای مثال برای چک کردن گواهی سایت خودم که معتبره</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="syntax"><code>python3 main.py behroozam.com 443
</code></pre></div></div>

<p>و برای یه گواهی نامعتبر از این مثالی که <a href="https://www.digicert.com/kb/digicert-root-certificates.htm">Digicert</a> استفاده میکنم</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="syntax"><code>python3 main.py digicert-tls-ecc-p384-root-g5-revoked.chain-demos.digicert.com 443
</code></pre></div></div>]]></content><author><name>Behrouz Hasanbeygi</name></author><category term="development" /><summary type="html"><![CDATA[گاهی وقت ها لازم میشه که قبل از اینکه یه گواهی نامه SSL به پایان برسه ما اون رو revoke کنیم]]></summary><media:thumbnail xmlns:media="http://search.yahoo.com/mrss/" url="https://behroozam.com/assets/article_images/certificate-revoke/crl-vs-ocsp.png" /><media:content medium="image" url="https://behroozam.com/assets/article_images/certificate-revoke/crl-vs-ocsp.png" xmlns:media="http://search.yahoo.com/mrss/" /></entry><entry><title type="html">ساختن کلید متقارن یا رمز به وسیله openssl ؟</title><link href="https://behroozam.com/how-to-generate-random-number-openssl.html" rel="alternate" type="text/html" title="ساختن کلید متقارن یا رمز به وسیله openssl ؟" /><published>2023-09-21T00:00:00+00:00</published><updated>2023-09-21T00:00:00+00:00</updated><id>https://behroozam.com/how-to-generate-random-number-openssl</id><content type="html" xml:base="https://behroozam.com/how-to-generate-random-number-openssl.html"><![CDATA[<h3 id="یه-مقدمه-کوتاه-درمورد-اعداد-رندوم">یه مقدمه کوتاه درمورد اعداد رندوم</h3>

<p>خیلی وقت ها پیش میاد که لازم باشه برای انکود و دیکود کردن فایل ها یا ساختن پسورد ها نیاز به یه اپلیکیشن دم دستی داشته باشیم که برامون سریع یه رشته رندوم رو به عنوان کلید متقارن یا رمز بسازه</p>

<p>یکی از بهترین ابزارها برای این کار <a href="https://www.openssl.org/docs/manmaster/man1/openssl-rand.html">openssl rand</a> هستش که یه <a href="https://en.wikipedia.org/wiki/Pseudorandom_number_generator">DRBG</a> یا به عبارت دیگه deterministic random bit generator است.</p>

<h3 id="منظور-ازdeterministic-random-bit-generator-چیه">منظور ازdeterministic random bit generator چیه؟</h3>

<p>تو دنیای واقعی برای ساختن عدد رندوم ( رمز یا کلید متقارن ) باید بریم سراغ زبان های برنامه نویسی و الگوریتم هایی که برای ساختن این اعداد ساخته شده
فانکشن های زبان های برنامه نویسی همواره یه ورودی و یه خروجی دارن و اون وسط یه سری عملیات هستش که ورودی ما رو به خروجی تبدیل میکنه.<br />
با این تفاسیر پس همیشه ما باید انتظار عدد یکسانی رو داشته باشیم چون
<code class="language-bash highlighter-rouge">f<span class="o">(</span>x<span class="o">)</span> <span class="o">=</span> x2</code>
اما برای رفع این مسئله از چیزی استفاده میشه به عنوان <a href="https://en.wikipedia.org/wiki/Random_seed">seed</a> یا دانه که مقدار اولیه که قراره به فانکشن ما داده بشه رو هربار عوض میکنه تا خروجی فانکشن ما همیشه متفاوت باشه ولی این مقدار اولیه هم خودش رندوم واقعی نیست و از مثلا زمان کامپیوتر یا پوینتر ماوس برای مقدار اولیه استفاده میکنه به همین دلیله که به این الگوریتم ها میگن pseudorandom number generators چون درنهایت اگه ما مقدار اولیه و روش کار الگوریتم رو بدونیم میتونیم که رشته اعداد رو بازتولید کنیم.</p>

<p>توجه کنید که این مبحث اعداد رندوم تو علوم کامپیوتر یکی از مهم ترین و کاربردی ترین قسمت ها هستش و این توضیح بالا ورژن خیلی ساده شده بحثه پس اگه به موضوع علاقه مند شدین توصیه میکنم این <a href="https://www.digitalocean.com/community/tutorials/random-number-generator-c-plus-plus">مقاله</a> رو درمورد اینکه چطور به وسیله CPP یه random number generator رو بنویسیم بخونید.</p>

<h3 id="ویژگی-های-یه-عدد-رندوم-خوب-چیه">ویژگی های یه عدد رندوم خوب چیه؟</h3>

<p>اما یه عدد رندوم مناسب باید چه ویژگی هایی داشته باشه:</p>

<ol>
  <li>همه اعداد از شانس برابرانتخاب شدن برخوردار باشن</li>
  <li>مستقل باشه یعنی نسبت به اعدادی که انتخاب شدن یا انتخاب خواهند شد رابطه ای برقرار نباشه ( مثلا تصاعد هندسی در اعداد برقرار نباشه )</li>
</ol>

<h3 id="چطوری-به-وسیله-openssl-rand-یه-رشته-تصادفی-بسازیم">چطوری به وسیله openssl rand یه رشته تصادفی بسازیم؟</h3>

<p>برنامه openssl رو تقریبا میشه روی همه سیستم عامل های مدرن gnu/linux و posix پیدا کرد و کاربرد های زیادی داره که از حوصله این مقاله خارجه ولی اگه سری به man page قسمت openssl rand بزنیم میبینیم که از چند تا اپشن پشتیبانی میکنه</p>

<p>به صورت پیشفرض خروجی که openssl rand داره یه رشته رندوم Bytes هستش تو اکثر مواقع این رشته به درد کار ما نمیخوره چون encoding خاصی نداره و برای اکثر نرم افزارها غیرقابل خوندنه.</p>

<p>یعنی اگه تایپ کنیم <code class="language-bash highlighter-rouge">openssl rand 64</code> برنامه ما یه رشته به اندازه 64 bytes ایجاد میکنه</p>

<p>اما دوتا آپشن کاربردی دیگه hex و base64 هستن یعنی خروجی بایتی رو که برنامه openssl ایجاد کرده به base64 یا hexadecimal تبدیل میکنه</p>

<h4 id="base64">base64</h4>

<p>اما فرمول سایز رشته خروجی ما چی هستش</p>

<p>تو استاندارد base64 هر کاراکتر 6 bit هستش و از سه تا بلاک 8 bit ای ساخته شده به عبارتی هرکاراکتر ما مثل عدد یا حرف به 24 bit و 4 تا کاراکتر base64 تبدیل میشه.</p>

<p>تصور کنید که ما خروجی یه رشته 32 بایتی رو از base64 انتظار داریم</p>

<p>پس تو فرمول ما <code class="language-bash highlighter-rouge">4<span class="k">*</span><span class="o">(</span>n/3<span class="o">)=</span>32</code> مقدار n میشه 24 بایت
چرا چون هر 3 تا بایت میشه یه کاراکتر base64 که خودش 4 تا کاراکتر utf8 میشه پس با این حساب ما به 24 بایت مقدار اولیه برای ساختن یه رشته 32 کاراکتری احتیاج داریم.</p>

<p>که به این صورت میتونیم یه رشته رندوم 32 بایتی رو به وسیله openssl بسازیم و انکود کنیم</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="syntax"><code>openssl rand <span class="nt">-base64</span> 24
</code></pre></div></div>

<h5 id="اگه-نیاز-به-یه-رشته-64-بیتی-یا-31-بیتی-داشتیم-چی">اگه نیاز به یه رشته 64 بیتی یا 31 بیتی داشتیم چی؟</h5>

<p>از اونجایی که مقدار 64 رند هستش و باقیمانده در تقسیم نداره کار محاسبه راحته کافیه مقدار 64 رو تو فرمول خودمون قرار بدیم <code class="language-bash highlighter-rouge">4<span class="k">*</span><span class="o">(</span>n/3<span class="o">)=</span>64</code> که میشه 48</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="syntax"><code>openssl rand <span class="nt">-base64</span> 48 | <span class="nb">tr</span> <span class="nt">-d</span> <span class="s1">'\n'</span> | <span class="nb">wc</span> <span class="nt">-m</span>
</code></pre></div></div>

<p>مشاهده میکنیم که اندازه خروجی ما 64 کاراکتر یا به عبارت دیگه 64 بایته.</p>

<p>برای محاسبه 31 بیت باید تو فرمول خودمون عددمون رو گرد کنیم
یعنی <code class="language-bash highlighter-rouge">4<span class="k">*</span><span class="o">(</span>n/3<span class="o">)=</span>31</code> که خروجیش میشه 32 یعنی به صورت دقیق نمیتونیم 31 بایت داشته باشیم</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="syntax"><code>openssl rand <span class="nt">-base64</span> 23 | <span class="nb">tr</span> <span class="nt">-d</span> <span class="s1">'\n'</span> | <span class="nb">wc</span> <span class="nt">-m</span>
</code></pre></div></div>

<h4 id="hex">Hex</h4>

<p>هر کاراکتر تو مقیاس هگزادسیمال 4bit هستش یعنی هر بایت تبدیل میشه به دو کاراکتر هگزادسیمال
به همین سادگی میتونیم از فرمول n/2 استفاده کنیم
یعنی اگه نیاز به 24 بایت خروجی داشته باشیم کافیه 24/2=12 رو به دست بیاریم</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="syntax"><code>openssl rand <span class="nt">-hex</span> 12
openssl rand <span class="nt">-hex</span> 12 | <span class="nb">tr</span> <span class="nt">-d</span> <span class="s1">'\n'</span> | <span class="nb">wc</span> <span class="nt">-m</span>
</code></pre></div></div>]]></content><author><name>Behrouz Hasanbeygi</name></author><category term="development" /><summary type="html"><![CDATA[یه مقدمه کوتاه درمورد اعداد رندوم]]></summary><media:thumbnail xmlns:media="http://search.yahoo.com/mrss/" url="https://behroozam.com/assets/article_images/openssl/openssl-logo.png" /><media:content medium="image" url="https://behroozam.com/assets/article_images/openssl/openssl-logo.png" xmlns:media="http://search.yahoo.com/mrss/" /></entry><entry><title type="html">من چطوری دیتا رو پردازش میکنم ؟</title><link href="https://behroozam.com/comparison-of-preprocessing-data-tools.html" rel="alternate" type="text/html" title="من چطوری دیتا رو پردازش میکنم ؟" /><published>2023-07-24T00:00:00+00:00</published><updated>2023-07-24T00:00:00+00:00</updated><id>https://behroozam.com/comparison-of-preprocessing-data-tools</id><content type="html" xml:base="https://behroozam.com/comparison-of-preprocessing-data-tools.html"><![CDATA[<h3 id="مقدمه">مقدمه</h3>

<p>یکی از کارهایی که که تو زیرساخت به تناوب تکرار میشه گزارش گیری و مقایسه منابع هستش مخصوصا زمانی که replication داریم و یا میخوایم از دیتامون بکاپ داشته باشیم یا تحلیل لاگ webserver برای پیدا کردن خطا …</p>

<p>از پراستفاده ترین مدل این مقایسه ها میشه به</p>
<ul>
  <li>union(full join)</li>
  <li>intersection(inner join)</li>
  <li>complement(right or left join)</li>
</ul>

<p>اشاره کرد.</p>

<p><img src="assets/article_images/data-pre-processing/sqljoins.jpg" alt="" title="sql joins" /></p>

<p>در ادامه میخوام درمورد ابزارهایی که برای پردازش این دیتا استفاده میکنم صحبت کنم</p>

<h3 id="awk">awk</h3>
<p>ساده ترین نوع مقایسه این مجموعه ها اینه که تو unix از <code class="language-bash highlighter-rouge"><span class="nb">awk</span></code> برای گزارش های خودمون استفاده کنیم که ابزار خوب و ساده و سریعیه و میتونه میلیون ها رکورد روبه سرعت مقایسه کنه اما استفاده از <code class="language-bash highlighter-rouge"><span class="nb">awk</span></code> ضعف هایی هم داره مخصوصا زمانی که حجم داده یا منطق کد پیچیده تر میشه</p>
<ul>
  <li>
    <p>awk برای مقایسه field ها character های اون ها رو باهم مقایسه میکنه و از hash map و الگوریتم های membership checking یا دیتا استراکچری مثل <a href="https://en.wikipedia.org/wiki/Binary_tree">binray tree</a> استفاده نمیکنه این به خودی خودش ضعف محسوب نمیشه ولی وقتی حجم و پیچیدگی دیتا از یه حدی بیشتر میشه سرعت پردازش رو خیلی کاهش میده یا مصرف حافظه رو به حدی بالا میبره که باعث میشه سیستم عامل برنامه awk ما رو Kill کنه</p>
  </li>
  <li>
    <p>برای استفاده موثر از awk باید از ابزار های دیگه unix مثل <code class="language-bash highlighter-rouge"><span class="nb">uniq</span></code> و <code class="language-bash highlighter-rouge"><span class="nb">sort</span></code> برای مرتب کردن دیتا استفاده کرد که خوانایی کد رو پایین میاره و نیازمند تکراره( به دلیل همون مسئله ای که بالاگفتم چون awk کاراکتر ها رو باهم مقایسه میکنه اگه فایل ما sort شده باشه سرعت این مقایسه بیشتر میشه )</p>
  </li>
</ul>

<h3 id="python">python</h3>
<p>راه حل جایگزین دیگه استفاده از پایتون ( یا هر زبان برنامه نویسی دیگه ای ) هستش
اما پایتون هم با وجود قدرت و انعطاف پذیری که داره محدودیت هایی برای ما داره همون طوری که میدونید پایتون یه زبان سطح بالا هستش که object ها رو تو memory ذخیره میکنه و اگه ما خودمون به صورت منطقی این memory managment رو انجام ندیم احتمال اینکه برنامه ما برای رکورد های حجیم توسط OOM سیستم عامل kill بشه بالا است. و این کار یعنی memory managment هم ساده نیست و نیازه که منطق کد تغییر کنه</p>

<p>مورد دیگه اینه که پایتون به خودی خودش به صورت بهینه از تمامی منابع سیستم استفاده نمیکنه و تو حالت عادی single thread هستش و برای استفاده بهینه از منابع باید از روش های پیچیده تر استفاده کرد</p>

<p>اما استفاده از پایتون مزیت هایی هم داره:</p>

<ul>
  <li>برای سناریو هایی که لازمه دیتا از منابع مختلف جمع آوری بشه و منطق برنامه پیچیده تره</li>
  <li>ایجاد وب سرویس به سادگی برای پردازش دیتا ورودی و خروجی</li>
</ul>

<h3 id="sql-databases">SQL databases</h3>
<p>راه حل سوم و پیشنهادی برای دیتای حجیم و پیچیده استفاده از database engine ها برای اینکار هستش به چند دلیل</p>

<ul>
  <li>
    <p>این نرم افزارهای عموما DBMS برای کار با دیتا حجیم ساخته شدن و بحث memory managment موقع طراحی نرم افزار اعمال شده</p>
  </li>
  <li>
    <p>زبان Query که استفاده میشه معمولا sql هستش و این زبان قدرتمند این قابلیت رو به ما میده که از operator های این زبان برای مجموعه ها استفاده کنیم.</p>
  </li>
  <li>
    <p>برای عملیات های پیچیده با شروط مختلف که نیازمند درنظر گرفتن پارامتر های زیادی هستش میشه از کوئری های تودرتو استفاده کرد</p>
  </li>
  <li>
    <p>برای بهینه کردن کوئری های SQL خود DBMS ها ابزارهای مفیدی دارن که آنالیز کوئری رو راحت میکنه</p>
  </li>
  <li>
    <p>برنامه های DBMS از دهه شصت میلادی به این سو وجود داشتن و همواره درحال بهبود و بهتر شدن بودن طبیعیه که سرعت و دقت و مصرف منابعشون به شدت بهینه تر باشه</p>
  </li>
  <li>
    <p>اکثریت DBMS های مدرن امکان sharding و replication رو به ما میدن که برای پردازش حجم بسیار زیادی از داده دست ما رو باز میزاره</p>
  </li>
</ul>

<p>برای درک بهتر این مسئله میریم سراغ یه مثال و بعدش راه حل های مختلفی که این سه ابزار یعنی awk و python و sqlite3 جلوی ما میزارن</p>

<h3 id="گزارش-گیری-از-اشتراک-دو-مجموعه">گزارش گیری از اشتراک دو مجموعه</h3>

<p>موردی که من باهاش مواجه شدم بحث گزارش گیری از دو storage account مختلف روی azure بود و من این کار رو به وسیله ابزار <a href="https://rclone.org/">rclone</a> انجام دادم که به مراتب سریع تر از <a href="https://learn.microsoft.com/en-us/powershell/module/az.storage/get-azstorageblob?view=azps-10.1.0">cmdlet</a> های خود مایکروسافت هستش.</p>

<p>سوای اینکه چطور میشه از object هایی که روی cloud هست گزارش گرفت بحث اصلی مقایسه این دوتا دیتاست هستش که درادامه سعی میکنم ابتدا دیتایی مشابه(sample data) رو ایجاد کنم و بعدش روش های مختلفی که میشه این دوتا رو باهم مقایسه کرد رو برسی کنیم</p>

<p>برای اینکه sample data رو بسازیم به سه شرط احتیاج داریم</p>
<ul>
  <li>دیتا یکتا در مبدا (source)</li>
  <li>دیتا یکتا در مقصد(destination)</li>
  <li>دیتا مشترک بین source و destination</li>
</ul>

<p>اینجوری ما یه مجموعه(set) خواهیم داشت که باهم یه سری اعضا رو به اشتراک گذاشته ان.</p>

<p>برای ساختن دیتا sample روی bash</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="syntax"><code><span class="c">#creating source objects</span>

<span class="k">for </span>i <span class="k">in</span> <span class="o">{</span>0..10000000<span class="o">}</span>
<span class="k">do
  </span><span class="nb">echo</span> <span class="s2">"object</span><span class="nv">$i</span><span class="s2">"</span> <span class="o">&gt;&gt;</span> source.txt
<span class="k">done</span>

<span class="c"># creating destination objects</span>

 <span class="k">for </span>i <span class="k">in</span> <span class="o">{</span>5000000..15000000<span class="o">}</span>
<span class="k">do
  </span><span class="nb">echo</span> <span class="s2">"object</span><span class="nv">$i</span><span class="s2">"</span> <span class="o">&gt;&gt;</span> dest.txt
<span class="k">done</span>

</code></pre></div></div>
<p>با کامند بالا حالا ما دوتا فایل <code class="language-bash highlighter-rouge">source.txt</code> و <code class="language-bash highlighter-rouge">dest.txt</code>داریم که 5 میلیون آبجکت مشترک دارند</p>

<h4 id="گزارش-گیری-به-وسیله-awk">گزارش گیری به وسیله awk</h4>

<p>برای اینکه اشتراک بین دوتا مجموعه رو به دست بیاریم باید column های این دوتا فایل رو باهم مقایسه کنیم
خوندن <a href="https://www.cs.princeton.edu/courses/archive/spr04/cos333/03awk">این مقاله</a> رو برای فهمیدن اجزای مختلف کامند های AWK توصیه میکنم ولی اگر کد پایین رو بشکونیم ما چند تا منطق رو داریم</p>
<ul>
  <li>
    <p><code class="language-bash highlighter-rouge"><span class="nv">FNR</span><span class="o">==</span>NR</code> به این معنی هستش که آخرین رکوردی<sup id="fnref:1"><a href="#fn:1" class="footnote" rel="footnote" role="doc-noteref">1</a></sup>  که <code class="language-bash highlighter-rouge">AWK</code> محاسبه میکنه به تعداد خطوطی که تو فایل اول یعنی <code class="language-bash highlighter-rouge">source.txt</code> وجود داره علت این مسئله هم برمیگرده به رفتار awk که تا زمانی که NR بزرگ میشه به کارش ادامه میده. تو حالت عادی NR مجموع تعداد خطوطی هستش که تو دوتا فایل وجود داره ولی وقتی ما <code class="language-bash highlighter-rouge"><span class="nv">FNR</span><span class="o">=</span>NR</code> قرار میدیم <code class="language-bash highlighter-rouge">NR</code> برابر با تعداد خطوط فایل اول یعنی <code class="language-bash highlighter-rouge">source.txt</code> میشه.</p>
  </li>
  <li>
    <p>مرحله دوم ریختن مقدار اولین field لاگ ما یعنی <code class="language-bash highlighter-rouge">object[ID]</code> تو یه متغیر به اسم <code class="language-bash highlighter-rouge">found</code> هستش</p>
  </li>
  <li>
    <p>مرحله بعدی مقایسه این متغیر با اولین field فایل دوم یعنی <code class="language-bash highlighter-rouge">dest.txt</code> هستش</p>
    <div class="language-bash highlighter-rouge"><div class="highlight"><pre class="syntax"><code><span class="nb">awk</span> <span class="s1">'FNR==NR{found[$1]++; next} $1 in found'</span> source.txt dest.txt
</code></pre></div>    </div>
  </li>
</ul>

<p>اجرا شدن این کد روی سیستم من حدود 5 ثانیه وقت گرفت که میتونه به نسبت کامپیوتر و میزان فضای پردازشی شما متفاوت باشه ولی برای یه گزارش گیری سریع محسوب میشه و به نظرم روش های بعدی براش overkill محسوب میشن پس سعی میکنم حجم داده و پیچیدگیش رو کمی بیشتر کنم تا محدودیت ها خودش رو بیشتر نشون بده.</p>

<h4 id="گزارش-گیری-به-وسیله-python">گزارش گیری به وسیله python</h4>

<p>همون طور که <a href="#python">بالا</a> به اون اشاره کردم روش های زیادی برای کار با دیتا تو پایتون وجود داره و معمولا رابطه مستقیمی بای این داره که حجم و پیچیدگی دیتا شما به چه صورت هستش مثلا برای دیتا بالا که به وسیله awk پردازشش کردیم کد مشابه پایتونی میتونه به این صورت و به وسیله set که builtin datastrucure خود پایتون هست انجام بشه</p>
<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="syntax"><code>import sys
import csv

sourceblobs <span class="o">=</span> frozenset<span class="o">(</span>line.strip<span class="o">()</span> <span class="k">for </span>line <span class="k">in </span>open<span class="o">(</span><span class="s2">"source.txt"</span><span class="o">)</span>.readlines<span class="o">())</span>
destinationblobs <span class="o">=</span> frozenset<span class="o">(</span>line.strip<span class="o">()</span> <span class="k">for </span>line <span class="k">in </span>open<span class="o">(</span><span class="s2">"dest.txt"</span><span class="o">)</span>.readlines<span class="o">())</span>
<span class="c"># get the size of sets</span>
print<span class="o">(</span><span class="s2">"size of the source blob"</span>, sys.getsizeof<span class="o">(</span>sourceblobs<span class="o">))</span>
print<span class="o">(</span><span class="s2">"size of the destination blob"</span>, sys.getsizeof<span class="o">(</span>destinationblobs<span class="o">))</span>

<span class="c">#sharedobject = frozenset( sourceblobs &amp; destinationblobs )</span>
intersection <span class="o">=</span> sourceblobs &amp; destinationblobs

with open<span class="o">(</span><span class="s1">'report.csv'</span>, <span class="s1">'w'</span><span class="o">)</span> as f:
    write <span class="o">=</span> csv.writer<span class="o">(</span>f<span class="o">)</span>
    write.writerow<span class="o">([</span><span class="s1">'Filename'</span><span class="o">])</span>
    <span class="k">for </span>item <span class="k">in </span>intersection:
        write.writerow<span class="o">([</span>item]<span class="o">)</span>

</code></pre></div></div>

<h5 id="ولی-اگه-حجم-دیتا-از-یه-حدی-بیشتر-بود-چی">ولی اگه حجم دیتا از یه حدی بیشتر بود چی؟</h5>

<p>خب برای ساختن دیتاست بزرگتر bash نمیتونه ابزار خوبی باشه چون while به اندازه کافی سرعت مناسبی رو نداره پس دست به دامن python میشیم برای ساختن دیتاست خودمون.</p>
<blockquote>
  <p>برای ساختن دیتاست شبیه به دنیای واقعی مثل آدرس و اسم و بقیه رکورد های معمول بهتره که از ابزارهایی که برای این کار موجوده مثل <a href="https://faker.readthedocs.io/en/master/">faker</a> استفاده کرد</p>
</blockquote>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="syntax"><code>def create_huge_log<span class="o">(</span>outputfile_location,start_range,end_range<span class="o">)</span>:
    with open<span class="o">(</span>outputfile_location, <span class="s1">'a'</span><span class="o">)</span> as outfile:
        <span class="k">for </span>item <span class="k">in </span>range<span class="o">(</span>start_range,end_range<span class="o">)</span>:
            outfile.write<span class="o">(</span><span class="s2">"object"</span> + str<span class="o">(</span>item<span class="o">)</span> + <span class="s1">'\n'</span><span class="o">)</span>

create_huge_log<span class="o">(</span><span class="s2">"./source_huge"</span>,1,100000000<span class="o">)</span>
create_huge_log<span class="o">(</span><span class="s2">"./dest_huge"</span>,50000000,150000000<span class="o">)</span>

</code></pre></div></div>

<p>با اجرا کردن همون کامند awk اگه میزان رم سیستم شما مثل من محدود باشه سیستم عامل به دلیل مصرف بیش از حد رم کامند awk شما رو kill میکنه</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="syntax"><code><span class="nb">awk</span> <span class="s1">'FNR==NR{found[$1]++; next} $1 in found'</span> source_huge dest_huge <span class="o">&gt;</span> tmp
</code></pre></div></div>
<p>پس باید به سراغ یه راه حل جایگزین رفت یعنی استفاده از دیتاتایپ یا روش دیگه ای برای برای پردازش دیتا خودمون</p>

<h5 id="استفاده-از-dask-برای-پردازش-دیتا-تو-حجم-زیاد">استفاده از dask برای پردازش دیتا تو حجم زیاد</h5>

<p>اگه قبلا از pandas که یکی از محبوب ترین پکیج های پایتون برای پردازش dataframe های خودتون استفاده کرده باشین حتما به محدودیت های حافظه برخورد کردین . 
برای رفع این مسئله یه پکیج پایتونی به اسم dask وجود داره که به جای اینکه یبارکی تمام دیتا شما رو تو یه dataframe لود کنه اون رو به پارتیشن های مختلف میشکونه و اینجوری باعث میشه که لود شدن دیتا در مقایسه با set یا panda dataframe خیلی سریعتر باشه ولی یه tradeoff هم داره که به نسبت حجم داده سرعت پردازش هم پایین تر میاد.</p>

<ol>
  <li>خوندن <a href="https://pub.towardsai.net/python-pandas-vs-dask-dataframes-a-comparative-analysis-c0f59dad5eeb#:~:text=Pandas%20is%20better%20suited%20for,choice%20for%20handling%20larger%20datasets.">این مقاله</a> برای مقایسه pandas و dask رو توصیه میکنم.</li>
  <li>خوندن <a href="https://rcpedia.stanford.edu/topicGuides/merging_data_sets_dask.html">این مقاله</a> برای استفاده از dask برای عملیات merge رو توصیه میکنم.</li>
</ol>

<p>یه خوبی دیگه که dask رو میتونه برای استفاده های جدی تر به گزینه خوبی تبدیل کنه اینه که multithread هستش و میتونه distributed روی ماشین های مختلفی اجرا بشه که ضعف سرعت در مقایسه با بقیه ابزارهایی که همه چیز روی RAM لود میشه کمتر بشه.</p>

<p>اما بریم سراغ کد :</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="syntax"><code>import dask.dataframe as <span class="nb">dd

</span>source_data_frame <span class="o">=</span> dd.read_csv<span class="o">(</span>r<span class="s2">"./source_huge"</span><span class="o">)</span>
dest_data_frame <span class="o">=</span> dd.read_csv<span class="o">(</span>r<span class="s2">"./dest_huge"</span><span class="o">)</span>

merged <span class="o">=</span> dd.merge<span class="o">(</span>source_data_frame, dest_data_frame, <span class="nv">on</span><span class="o">=[</span><span class="s2">"log"</span><span class="o">]</span>, <span class="nv">how</span><span class="o">=</span><span class="s1">'inner'</span><span class="o">)</span>

merged.to_csv<span class="o">(</span><span class="s1">'./report.csv'</span>, single_file <span class="o">=</span> True<span class="o">)</span>
</code></pre></div></div>

<p>همون طور که متوجه شدین سرعت بزرگترین مزیت استفاده از dask نیست ولی میتونید مطمعا باشید که برنامه شما به خاطر مصرف تمام حافظه kill نمیشه.</p>

<h4 id="گزارش-گیری-به-وسیله-sqlite3">گزارش گیری به وسیله sqlite3</h4>
<p>دنیای SQL compatible database ها پر از اسامی پر افتخاری مثل Mysql و MS sql server و Postgresql و Mariadb هستش.</p>

<p>این بسته به تجربه و راحتی استفاده شما داره که کدوم یکی از این ها رو برای پردازش دیتا خودتون استفاده میکنید ولی برای تعداد خیلی زیادی از سناریو ها به نظر من دیتابیس سبک و قدرتمند sqlite پاسخگو هستش.</p>

<p>اما بریم سراغ پردازش دیتا خودمون.</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="syntax"><code><span class="c">#copy files to csv format </span>

<span class="nb">cp </span>dest_huge dest_huge.csv
<span class="nb">cp </span>source_huge source_huge.csv

<span class="c">#add csv field </span>
<span class="nb">sed</span>  <span class="nt">-i</span> <span class="s1">'1i log'</span> source_huge.csv
<span class="nb">sed</span>  <span class="nt">-i</span> <span class="s1">'1i log'</span> dest_huge.csv

<span class="c">#create tables and import data </span>

sqlite3 set.db
create table sourcelog<span class="o">(</span>log text<span class="o">)</span><span class="p">;</span>
create table destlog<span class="o">(</span>log text<span class="o">)</span><span class="p">;</span>
.import source_huge.csv sourcelog <span class="nt">--csv</span>
.import dest_huge.csv destlog <span class="nt">--csv</span>
.exit 

<span class="c">#run sql query to get intersect between two source and dest tabel </span>

sqlite3 <span class="nt">-header</span> <span class="nt">-csv</span> set.db <span class="s1">'SELECT * FROM sourcelog INTERSECT SELECT * FROM destlog;'</span> <span class="o">&gt;</span> intersect.csv
</code></pre></div></div>
<p>همون طور که متوجه شدین sqlite3 در مقایسه با بقیه ابزارها با سرعت خیلی بیشتری جواب میده</p>

<h3 id="نتیجه-گیری">نتیجه گیری</h3>

<p>شاید بپرسین با وجود اینکه دیدیم sqlite3 سریعتر از بقیه ابزارها جواب میده پس چرا بازم از اونا استفاده میکنیم؟</p>

<ul>
  <li>
    <p>برای iterate کردن با دیتا کم که معمولا اکثر اوقات دیتا ما حجیم نیست ابزاری مثل awk یا python خیلی کار دیباگ رو راحت و سریع میکنه</p>
  </li>
  <li>
    <p>برای مقایسه sql و dask به نظرم این <a href="https://docs.dask.org/en/latest/dataframe-sql.html">مقاله</a> خیلی خوب tradeoff ها رو توضیح داده</p>
  </li>
</ul>

<p>درنهایت انتخاب ابزار مناسب برای پردازش دیتا برایندی از مقیاس و پیچیدگی و زمان و منابع شما.</p>

<div class="footnotes" role="doc-endnotes">
  <ol>
    <li id="fn:1">
      <p>خط تو فایل لاگ ما FNR indicates how many records have been read from the current input file <a href="#fnref:1" class="reversefootnote" role="doc-backlink">&#8617;</a></p>
    </li>
  </ol>
</div>]]></content><author><name>Behrouz Hasanbeygi</name></author><category term="development" /><summary type="html"><![CDATA[مقدمه]]></summary><media:thumbnail xmlns:media="http://search.yahoo.com/mrss/" url="https://behroozam.com/assets/article_images/data-pre-processing/data-preparation-process.jpg" /><media:content medium="image" url="https://behroozam.com/assets/article_images/data-pre-processing/data-preparation-process.jpg" xmlns:media="http://search.yahoo.com/mrss/" /></entry><entry><title type="html">در ستایش مجموعه ها و کاربردشون در زندگی واقعی</title><link href="https://behroozam.com/practical-usage-of-sets-in-daily-life-md.html" rel="alternate" type="text/html" title="در ستایش مجموعه ها و کاربردشون در زندگی واقعی" /><published>2023-07-21T00:00:00+00:00</published><updated>2023-07-21T00:00:00+00:00</updated><id>https://behroozam.com/practical-usage-of-sets-in-daily-life.md</id><content type="html" xml:base="https://behroozam.com/practical-usage-of-sets-in-daily-life-md.html"><![CDATA[همه ما تو دوران تحصیلمون از اینکه کاربرد بعضی از مباحث چیه ناله کردیم. 
به نظرم این از ضعف سیستم آموزشی ما هم هستش البته که قبل از درست کردن احساس نیاز مستقیما میره سراغ فرو کردن یه مسئله به صورت کاملا محض تو مغز بچه های طفل معصوم. 

یکی از این مباحثی که خیلی بزرگی و کاربردش اون موقع ها به چشم نمیومد بحث مجموعه ها بود 

### اما مجموعه چی هستش ؟ 

> **مجموعه یه مدل ریاضیه برای گردآوری چیزهای مختلف.** 

خب این توصیف خیلی کلی و شاید ملموس نباشه بهتره از مثال استفاده کنیم 

مثلا تصور کنید که ما میخوایم اسم تمامی فایل هایی که تو یه دایرکتوری وجود داره رو جمع آوری کنیم این میشه ساختن یه مجموعه ای از اسامی فایل ها. به این صورت 

```
#create a temporary directory 
mkdir /tmp/sets
cd /tmp/sets

# in t in range between 1-100 create files with the number
# in the filename 

for i in {1..100};
 do touch TEST$i; 
done

#by listing the filenames we create a set 

ls -la 
```

یعنی ما یه صفت مثل اسم فایل رو مبنا قرار دادیم و بر این اساس اومدیم یه مجموعه ای از این اسامی ساختیم. 

### کاربرد مجموعه ها تو زندگی واقعی یه مهندس دواپس چیه؟]]></content><author><name>Behrouz Hasanbeygi</name></author><category term="development" /><summary type="html"><![CDATA[همه ما تو دوران تحصیلمون از اینکه کاربرد بعضی از مباحث چیه ناله کردیم. به نظرم این از ضعف سیستم آموزشی ما هم هستش البته که قبل از درست کردن احساس نیاز مستقیما میره سراغ فرو کردن یه مسئله به صورت کاملا محض تو مغز بچه های طفل معصوم.]]></summary><media:thumbnail xmlns:media="http://search.yahoo.com/mrss/" url="https://behroozam.com/assets/article_images/scammers/sellingdreams.jpg" /><media:content medium="image" url="https://behroozam.com/assets/article_images/scammers/sellingdreams.jpg" xmlns:media="http://search.yahoo.com/mrss/" /></entry><entry><title type="html">رویافروشی: روش های شناختی برای اینکه سرمون کلاه نره</title><link href="https://behroozam.com/cognitive-methods-to-deal-with-the-scammers.html" rel="alternate" type="text/html" title="رویافروشی: روش های شناختی برای اینکه سرمون کلاه نره" /><published>2023-07-20T00:00:00+00:00</published><updated>2023-07-20T00:00:00+00:00</updated><id>https://behroozam.com/cognitive-methods-to-deal-with-the-scammers</id><content type="html" xml:base="https://behroozam.com/cognitive-methods-to-deal-with-the-scammers.html"><![CDATA[<h3 id="تاریخچه-متخصری-از-بازاریابی">تاریخچه متخصری از بازاریابی</h3>

<p>تو دنیای قدیم وقتی یه بابایی یه دکون یا مغازه داشت منتظر میموند تا مشتری بیاد و چیزی رو ازش بخره 
تا سال های سال این روند وجود همینجوری ادامه داشت تا زمانی که مدیا و رسانه و خط تولید و انقلاب صنعتی بازار رو متحول کرد یعنی دیگه اوس محمود تو خونه خودش یه محصولی رو تولید نمیکرد که به دست مشتری برسونه و مشتری دیگه از طریق شنیدن از دوستان و اطرافیان متوجه کیفیت یه محصول نمیشد پس نقش تبلیغات از کیفیت بیشتر شد و روش های مارکتینگ هم عوض شد یعنی به جای باز کردن دکون و منتظر بودن برای مشتری حالا باید ما به دنبال مشتری میرفتیم.</p>

<p>اینجا بود که رویا فروشی تو دوران مدرن خلق شد یعنی فروش محصول بی کیفیت فقط به اتکا به هنر بازاریابی.</p>

<p>حالا ما با یک دنیایی مواجه هستیم که خریدار باید کیفیت محصولات رو تشخیص بده و این اغلب درمورد محصولاتی که شکل کالای فیزیکی رو ندارند مثل محصولات آموزشی یا ایده ها سخت تره یعنی نیاز به افراد متخصصی رو داره که محصولات رو برسی کرده باشن چون لزوما نمره یا ریت بالا تو سایت فروشنده به معنای واقعی بودن این نمرات نیست.</p>

<p>اما بریم سراغ مهارت هایی که تا حد زیادی میتونه ما رو نسبت به اکثریت کلاهبردار ها و فروشنده های زرنگ که دنبال انداختن کالای بنجل خودشون به ما هستن رو بگیره ( این ها کاملا تجربه های شخصی خودمه و هیچکدوم از کتاب یا مقاله دیگه ای نیست )</p>

<h3 id="روش-های-شناختی-برای-اینکه-سرمون-کلاه-نره">روش های شناختی برای اینکه سرمون کلاه نره</h3>
<ol>
  <li><strong>هیچ گربه ای برای رضای خدا موش نمیگیره</strong> این یه ضرب المثل معروف فارسیه که خیلی تو مواقعی که سعی داریم نیت آدم ها رو بشناسیم به ما کمک میکنه مثلا اگه یه مدیر محصول به ما ایمیل زد که بیا بریم ناهار باهمدیگه به حساب شرکت ما به احتمال زیاد میخواد مصول شرکتشون رو به شما بفروشه.
انگلیسی زبان ها هم  یه ضرب المثل مشابه دارن که میگه <a href="https://en.wikipedia.org/wiki/There_ain%27t_no_such_thing_as_a_free_lunch">There ain’t no such thing as a free lunch</a> یعنی ناهار مجانی وجود نداره.</li>
  <li><strong>نیاز های خودمون رو بشناسیم</strong> اینجوری اگه یه فروشنده با جاروبرقی پرنده به سراغمون اومد میتونیم بگیم بهش احتیاجی نداریم هرچند که جاروبرقی پرنده بهترین محصول دنیا باشه. اینشکلی هم تو فضا صرفه‌جویی کردیم هم تو پولی که خرج میکنیم هم در انتها حس احمق بودن برای خریدن محصولاتی که به هیچ دردی نمیخورن نخواهیم داشت.</li>
  <li><strong>بهینه جست و جو کنیم</strong>. با وجود اینترنت این روزها بدیهیه که جست و جو کردن اولین واکنش ما انسان مدرن نسبت به پیدا کردن اطلاعات نسبت به محصولات باشه 
مثلا اگه بخوایم مهارت جدیدی رو یاد بگیریم کافیه که سرچ کنیم ولی بهینه سرچ کردن با سرچ کردن به تنهایی متقاوته. تو جست و جوی بهینه ما صرفا روی اولین لینکی که گوگل به ما پیشنهاد میکنه کلیک نمیکنیم و همه اعتمادمون رو صدرصد پای اولین لینک نمیزاریم. همون طور که میدونید شرکت ها به گوگل بابت تبلیفات پول میدن و کلی هم هزینه َSEO میکنن که لینک اول باشن پس با دقت مقایسه کنید</li>
  <li><strong>از متخصصین سوال بپرسیم</strong>. همون جوری که برای معده درد به سراغ پزشک متخصص میرین برای سوال هایی مثل آینده کاری و اینکه چطور برنامه نویسی رو یاد بگیریم از متخصصین سوال کنید. بهترین جا هم برای پرسیدن این سوالات انجمن های تخصصی مثل reddit هستش.</li>
</ol>

<h3 id="سخن-آخر">سخن آخر</h3>
<p>اگه با وجود رعایت همه موارد بالا بازم گیر سخنان انگیزشی و آموزش دهنده های مکار افتادین به خودتون سخت نگیرید و سعی کنید از تجربیات خودتون درس بگیرین. همون جوری که شما روز به روز درحال پیشرفت هستین کلاهبردار ها و انگیزشی ها و رویافروش ها درحال به روز کردن روش های خودشون برای به قلاب انداختن هرچه بیشتر طعمه های خودشون هستند.</p>]]></content><author><name>Behrouz Hasanbeygi</name></author><category term="life" /><summary type="html"><![CDATA[تاریخچه متخصری از بازاریابی]]></summary><media:thumbnail xmlns:media="http://search.yahoo.com/mrss/" url="https://behroozam.com/assets/article_images/scammers/sellingdreams.jpg" /><media:content medium="image" url="https://behroozam.com/assets/article_images/scammers/sellingdreams.jpg" xmlns:media="http://search.yahoo.com/mrss/" /></entry><entry><title type="html">تعریف کردن class تو powershell</title><link href="https://behroozam.com/class-vs-variable-powershell.html" rel="alternate" type="text/html" title="تعریف کردن class تو powershell" /><published>2023-07-18T00:00:00+00:00</published><updated>2023-07-18T00:00:00+00:00</updated><id>https://behroozam.com/class-vs-variable-powershell</id><content type="html" xml:base="https://behroozam.com/class-vs-variable-powershell.html"><![CDATA[<h3 id="مقدمه">مقدمه</h3>

<p>به عنوان یه لینوکس ادمین هربار که مجبور میشدم سراغ کارهای پیچیده اسکریپتینگ برم راه حل تو لینوکس استفاده از Python بود به دو دلیل:</p>

<ol>
  <li>bash از <a href="https://en.wikipedia.org/wiki/Object-oriented_programming">OOP</a> ساپورت نمیکنه</li>
  <li>bash برای loop  های پی در پی گیج کننده است</li>
</ol>

<p>ولی تو اکوسیستم ماکروسافت استفاده از Python به دلیل <a href="https://learn.microsoft.com/en-us/powershell/scripting/developer/cmdlet/cmdlet-overview?view=powershell-7.3">cmdlet</a> های آماده ای که خود ماکروسافت در اختیار توسعه دهنده گذاشته انتخاب غلطیه.</p>

<p>تو پست قبلی درمورد مقایسه کردن powershell و bash از برتری powershell به خاطر object oriented بودنش گفتم یکی از مثال های بارز این قابلیت powershell تعریف custom object هستش.</p>

<p>میخوام سه مثال مقایسه تعریف variable و objects رو تو Python و Bash و Powershell بزنم تا راحت تر متوجه این تفاوت بشید</p>

<h3 id="تعریف-class-تو-python">تعریف class تو python</h3>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="syntax"><code>class Person:
  def __init__<span class="o">(</span>self, name, lastname, eyecolor,  age<span class="o">)</span>:
    self.FirstName <span class="o">=</span> name
    self.LastName <span class="o">=</span> lastname
    self.EyeColor <span class="o">=</span> eyecolor
    self.age <span class="o">=</span> age

p1 <span class="o">=</span> Person<span class="o">(</span><span class="s2">"John"</span>, <span class="s2">"Doe"</span>, <span class="s2">"Brown"</span>, 36<span class="o">)</span>

print<span class="o">(</span>p1.FirstName<span class="o">)</span>
print<span class="o">(</span>p1.LastName<span class="o">)</span>
</code></pre></div></div>

<h3 id="تعریف-class-تو-powershell">تعریف class تو Powershell</h3>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="syntax"><code>class Person <span class="o">{</span>
    <span class="o">[</span>String]<span class="nv">$FirstName</span>
    <span class="o">[</span>String]<span class="nv">$LastName</span>
    <span class="o">[</span>String]<span class="nv">$EyeColor</span>
    <span class="o">[</span>Int]<span class="nv">$Age</span>
<span class="o">}</span>

<span class="nv">$johnDoe</span> <span class="o">=</span> New-Object Person
<span class="nv">$johnDoe</span>.FirstName <span class="o">=</span> <span class="s1">'John'</span>
<span class="nv">$johnDoe</span>.LastName <span class="o">=</span> <span class="s1">'Doe'</span>
<span class="nv">$johnDoe</span>.EyeColor <span class="o">=</span> <span class="s1">'Brown'</span>
<span class="nv">$johnDoe</span>.Age <span class="o">=</span> 33

<span class="nv">$johnDoe</span>.FirstName
<span class="nv">$johnDoe</span>.LastName

</code></pre></div></div>

<h3 id="تعریف-variable-تو-bash">تعریف variable تو bash</h3>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="syntax"><code><span class="nv">name</span><span class="o">=</span><span class="s2">"John"</span> 
<span class="nv">lastname</span><span class="o">=</span><span class="s2">"Doe"</span>

<span class="nb">echo</span> <span class="nv">$name</span> 
<span class="nb">echo</span> <span class="nv">$lastname</span> 

</code></pre></div></div>

<h3 id="برتری-استفاده-از-class-نسبت-به-تعریف-variable-برای-هر-آبجکت-چیه-">برتری استفاده از class نسبت به تعریف variable برای هر آبجکت چیه ؟</h3>

<p>به صورت خلاصه برتری class نسبت به variable</p>

<ol>
  <li>کد ما درنهایت تمیز تر و خوانا تره و برای تغییر کافیه که class تغییر کنه</li>
  <li>از تکرار بیهوده جلوگیری میشه</li>
</ol>

<p>اگه تصور کنیم تعداد زیادی instance ما از هرکدوم از این class ها داشته باشیم Powershell و Python سربلند بیرون میان 
 برای مثال ما بخوایم فرد دیگه ای رو ثبت کنیم مثلا تو Powershell</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="syntax"><code><span class="nv">$mamad</span> <span class="o">=</span> New-Object Person
<span class="nv">$mamad</span>.FirstName <span class="o">=</span> <span class="s1">'mamad'</span>
<span class="nv">$mamad</span>.LastName <span class="o">=</span> <span class="s1">'gholi'</span>
<span class="nv">$mamad</span>.EyeColor <span class="o">=</span> <span class="s1">'Black'</span>
<span class="nv">$mamad</span>.Age <span class="o">=</span> 25

<span class="nv">$mamad</span>.FirstName
<span class="nv">$mamad</span>.LastName
</code></pre></div></div>

<p>ولی تو bash مجبوریم که به ازای هر مقدار جدیدی ما یه variable تعریف کنیم یا این محدودیت های bash رو به روش های دیگه ای دور بزنیم.</p>]]></content><author><name>Behrouz Hasanbeygi</name></author><category term="development" /><summary type="html"><![CDATA[مقدمه]]></summary><media:thumbnail xmlns:media="http://search.yahoo.com/mrss/" url="https://behroozam.com/assets/article_images/powershell/powershell.png" /><media:content medium="image" url="https://behroozam.com/assets/article_images/powershell/powershell.png" xmlns:media="http://search.yahoo.com/mrss/" /></entry></feed>